
Sheru Bhai 提示词:三层可复制的 20–30 秒竖屏 Prompt
把 Sheru Bhai 风格竖屏短片做到 20–30 秒的三层提示词:角色锁定参考图、故事母 Prompt、逐镜头运动 Prompt,附失败排查与水果版改写。
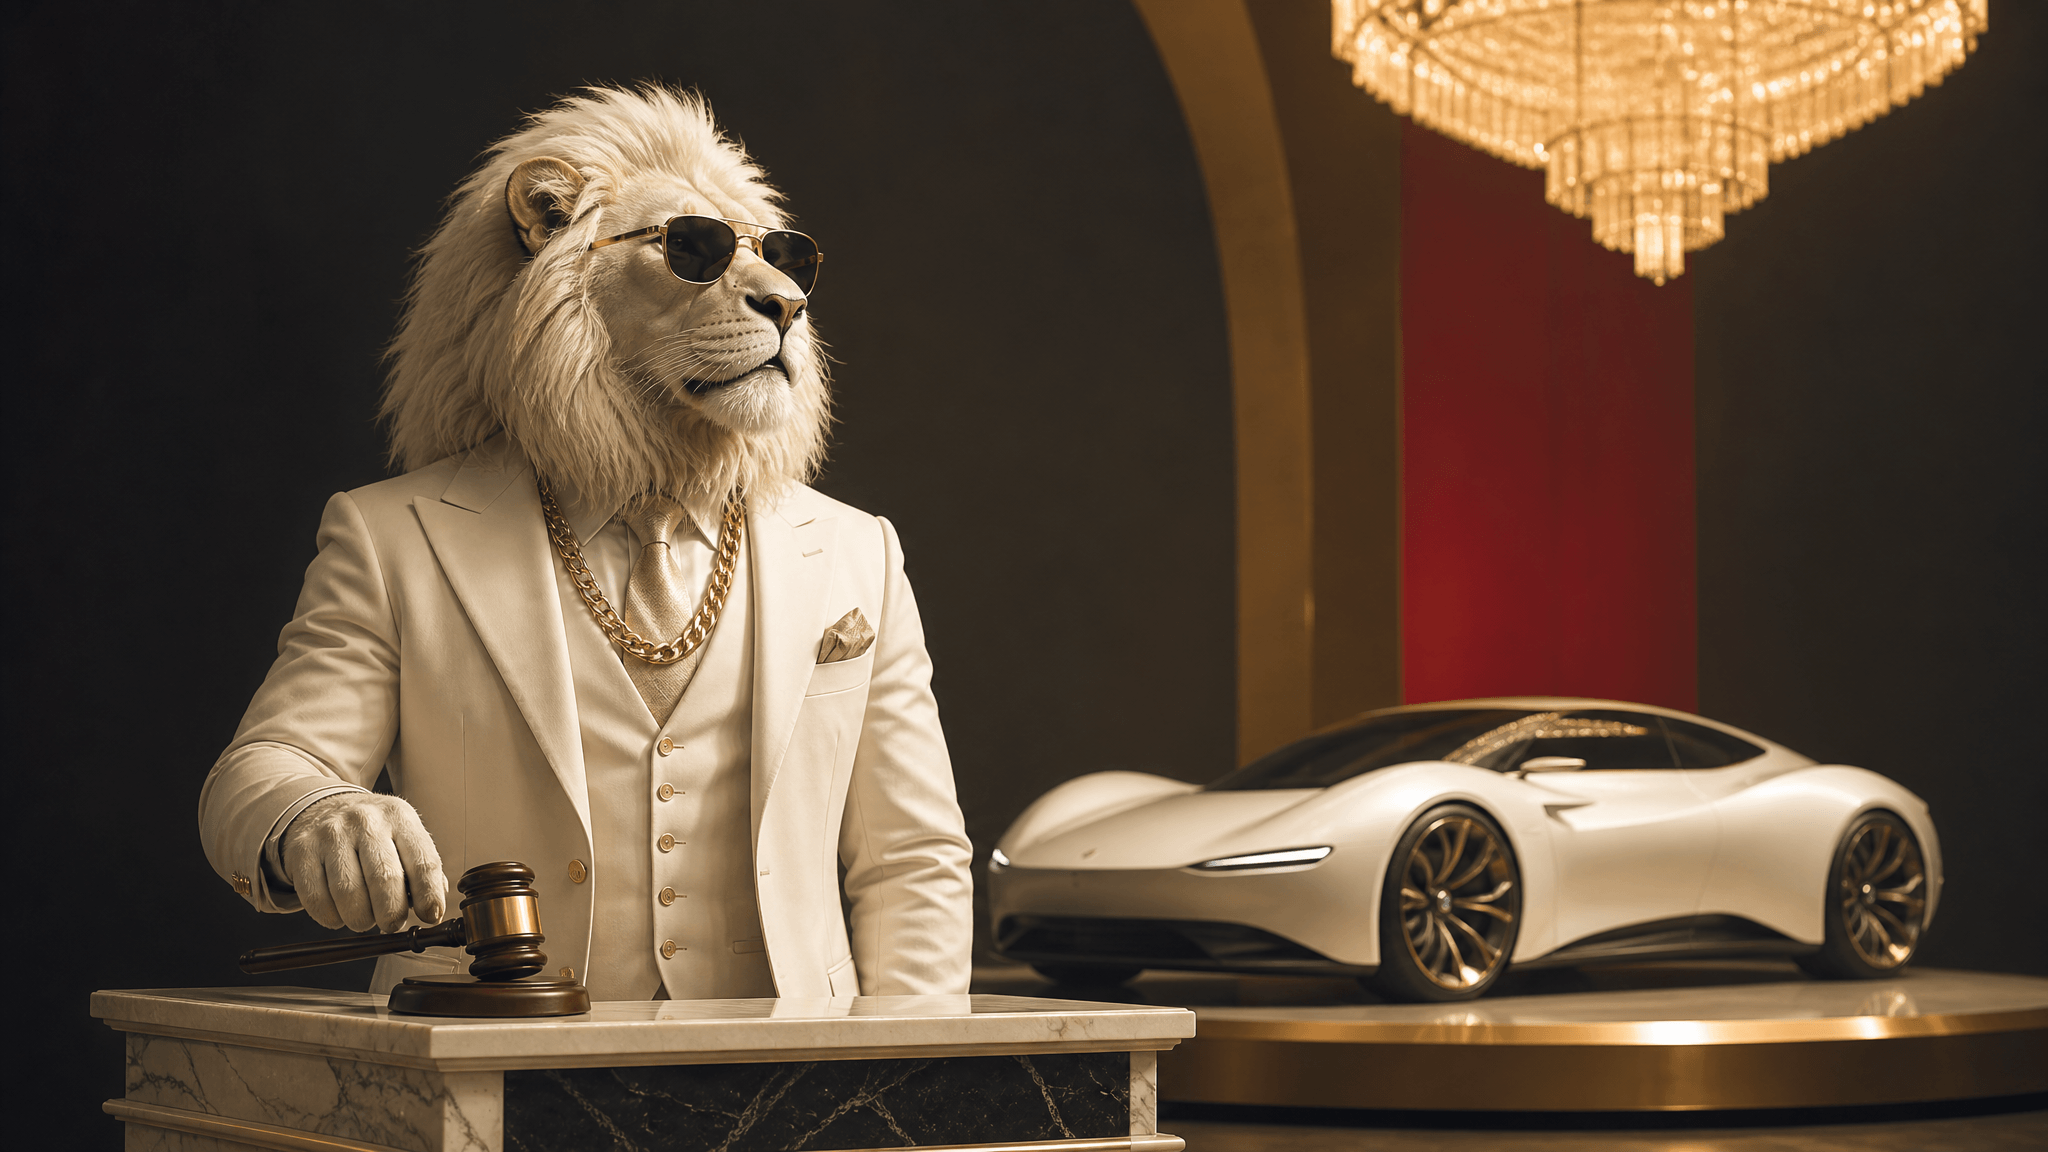
搜「sheru bhai video prompt」,多半会掉进一条 40 秒的 Reel 下面——满屏都是刷「PROMPT」的评论,而真正的提示词从头到尾没露过面。做出这类片子靠的不是一段能直接粘贴的文案,而是三层:给图像模型的角色锁定、给对话模型的故事母 Prompt,以及给每个 10 秒镜头的运动 Prompt。
这篇把三层都给出来,外加让狮子在每一帧都是同一只狮子的规则。以下每一段 Prompt 都来自 2026 年 11 月这波热潮里公开发布的材料——一份可下载的母 Prompt、两份教程、一个成文的提示词页面,再加上一篇带日期的起源时间线——并且标明了它负责解决哪个问题,你照着往对应的输入框里贴就行。
| 层级 | 锁住什么 | 贴到哪里 |
|---|---|---|
| 1. 角色锁定 | 脸、毛色、西装、金链、墨镜 | 图像模型,产出角色参考图 |
| 2. 故事母 Prompt | 节拍、台词、镜头数量、字数预算 | 对话模型 |
| 3. 单镜头运动 Prompt | 运镜、动作、声音、衔接 | 视频模型,一个镜头一段 |
Sheru Bhai 提示词到底要描述什么
Sheru Bhai 是 AI 短片里的一个狮子角色,被塑造成富到离谱的「bhai」。最常见的版本是一只直立行走的白狮,穿浅色三件套、戴粗金链和黑墨镜;其他账号会换毛色、服装和场景。Instagram 账号 @digitalsheru 自称是这个角色的创作者和源头;这是账号自己的说法,并非独立确认的著作权归属,角色也不是真人或真实品牌吉祥物(MuseSignal,2026-11-15 更新)。
格式和角色同样重要。按 MuseSignal 对 Google Trends 数据的带日期梳理,这波热潮在 2026 年 11 月 6 日前后开始被更广的人群注意到,11 月 10 日到 12 日急剧上升,到 11 月 15 日仍在往上走。两种格式占主流:一种是奢侈拍卖喜剧,Sheru 用荒唐的报价压过动物对手;另一种是逆袭短片,对手先羞辱他,十秒之内输得精光(Raj Photo Editing 母 Prompt,2026-11-13;Media.io 提示词页)。
所以一段提示词要同时扛住四件事:跨镜头不崩的身份、能在 20–30 秒里讲完的节拍、文本生成视频模型真能念出来的台词,以及竖屏构图。拆成三层不是讲究,而是让变量一次只动一个的唯一办法。
先说清一个前提:本文是文档型指南,复现的是已发布教程描述的工作流,不是我们跑过并计时、对标的实测结果。
第一层:角色锁定,做成参考图
只靠文字描述会漂移。你要「一只白狮穿白西装」六次,会得到六只狮子、六套西装、六条项链。这波教程里的做法是先把角色生成成一张参考图(reference sheet),之后每个场景都把它作为参考附件传进去(Kapwing 教程,2026-11-14)。
把下面这段贴进支持参考图的图像模型:
Character reference sheet: Sheru Bhai, one photoreal anthropomorphic adult
male white lion. Dense white fur, full white mane, amber eyes. Tailored
cream three-piece suit, white dress shirt, deep-red silk tie, thick gold
curb chain, brushed-gold watch, black rectangular sunglasses. Calm,
confident expression, upright human posture, broad shoulders.

Show the same character four times on one neutral studio background:
full-body front view, three-quarter view, side view, back view, identical
lighting and identical outfit in all four. Keep the face, mane shape, suit
cut and chain length identical between views. Photorealistic, 8k detail,
real individual fur strands, no text, no logos, no watermark, no other
characters.
接着再生成一张场景参考图——拍卖大厅、展厅、宫殿车道——里面不要有角色。Kapwing 的演示把它叫环境参考图,理由很实际:只给一张环境图,视频模型才不会再给每个镜头重新发明一个房间。
两个让参考图真正好用的习惯:
- 按竖屏取景生成参考图。 后面生成的是竖屏片段,一张宽幅参考图会逼模型先把你的人物裁掉一半再动画。
- 写明「不许变」的部分。「同一张脸、同一鬃毛、同一套西装版型」比一整段赞美更短也更有效。
第二层:故事母 Prompt
第二层是对话模型里的规划 Prompt——在任何图像或视频生成之前,先把整条片子排出来。流传最广的版本随 Raj Photo Editing 11 月 13 日的教程发布,它的结构值得照抄,因为每条规则都在解决一个具体的失败:
[VIDEO DURATION: 20 SECONDS]

You are writing a vertical short for Instagram Reels and YouTube Shorts
about Sheru Bhai, a rich white lion in a cream three-piece suit who
outbids animal rivals at absurd auctions.

PHASE 1 — Give me 10 numbered story ideas. Ideas 1-5: luxury auction wars
(rival animals, absurd prizes). Ideas 6-10: poor-to-rich comebacks (Sheru
is insulted, then transforms and wins). One title and one line each. Then
stop and ask which number I want.

PHASE 2 — After I pick a number, output only the clip prompts, each in its
own code block:
- 20 SECONDS = exactly 2 prompts of 10 seconds; 30 SECONDS = exactly 3
  prompts of 10 seconds.
- 14-18 spoken Hindi words per clip, written in Roman letters so the model
  can speak them.
- Speech starts within the first 0.5 seconds of every clip. No silent
  openings.
- Rivals speak plain, grounded Hindi. Only Sheru uses the nonsense bidding
  chain ("million, billion, trillion, quadrillion, gazillion") and the food
  and meme lines.
- The final 4 seconds show Sheru enjoying the exact prize he just won,
  rival defeated.
- Clip 2 (and 3) must open with: "Continuing seamlessly from the exact
  last frame of the previous clip."
把这几条规则读成「否则剪辑时一定会遇到的问题」:
- 用总时长决定镜头数。 一次只能出 10 秒的模型没法一口气给 30 秒,所以总时长必须先声明,再切分。
- 每个 10 秒 14–18 个词。 这大约是急促、不换气的语速。给 30 个词,配音要么被截断,要么糊成一团。
- 开口在 0.5 秒内。 短视频观众在第一拍沉默时就开始划走。要求台词立刻开始,等于删掉了你本来要手工剪掉的死镜头。
- 谁可以荒诞。 母 Prompt 把胡诌的数字串、街头小吃词和梗台词全部只给 Sheru,对手一律说正常印地语。这个反差本身就是笑点;所有人一起喊胡话,画面就只剩噪音。
- 最后四秒。 结尾随便抖个包袱是典型的失败。母 Prompt 强制把奖品落实:王冠戴在头上、钥匙握在爪里、倚着新车扶一下墨镜。
- 衔接句。 这是最便宜的一致性技巧:让下一代从上一段的最后一帧起手,而不是重新构图。
台词语言不必守着印地语。换语言是一行改动——但词数预算和「立刻开口」这两条要留着,因为它们是节奏决策,不是语言决策。镜头接力也不是必须:如果你走下面说的单次生成路线,改掉开头的时长声明,要求它给一段覆盖整段 20–30 秒的 Prompt,而不是两三个 10 秒块。
第三层:单镜头运动 Prompt
对话模型会吐出两三段文本,每一段单独送进视频模型,同时附上角色参考图和环境参考图。用这个骨架,保证没有任何一个镜头漏掉变量:
Continuity: continuing seamlessly from the exact last frame of the
  previous clip.
Subject: [the character-lock sentence from Layer 1]
Location: [environment from the environment sheet]
Prize: [the object being bid on]
Action: [who moves, who reacts, who wins this beat]
Camera: [one camera move — slow push-in, whip pan, crash zoom, low angle]
Dialogue: [14-18 words, romanized, speaker-labelled]
Audio: [room tone, gavel, light comic score]
Style: photorealistic 8k live-action cinema, 9:16 vertical, shallow depth
  of field
Avoid: duplicate characters, costume or mane changes, extra limbs,
  on-screen text, logos
填好之后,一场拍卖的开场长这样:
Continuity: continuing seamlessly from the exact last frame of the
  previous clip.
Subject: Sheru Bhai, the same photoreal white lion in the cream three-piece
  suit, red tie, gold curb chain and black rectangular sunglasses.
Location: a marble auction hall at night, warm chandeliers, red velvet
  bidders' row.
Prize: a pearl-white concept car on a rotating platform.
Action: the rival - a heavy grey elephant in a navy suit - slaps his
  paddle down and smirks. Sheru does not look at him; he adjusts one cuff,
  then raises his paddle without breaking eye contact with the platform.
Camera: slow push-in on the paddle, then whip pan to Sheru's face.
Dialogue: Elephant, plain Hindi: "Yeh gaadi meri, teri aukaat kya hai?"
  Sheru, calm: "Million, billion, trillion, quadrillion - ghop ghop
  dollar."
Audio: low room murmur, one gavel knock, restrained comic strings.
Style: photorealistic 8k live-action cinema, 9:16 vertical, shallow depth
  of field.
Avoid: duplicate characters, costume or mane changes, extra limbs,
  on-screen text, logos.
同一个骨架也能扛逆袭节拍——那种整段只为一个转变服务的镜头。角色的脸和鬃毛那句一字不改,把变化写进 Action 行(「先是破灰衬衫,转身时已经是米色三件套」),把剪切点写进 Camera 行,告诉模型变化发生在哪一刻。
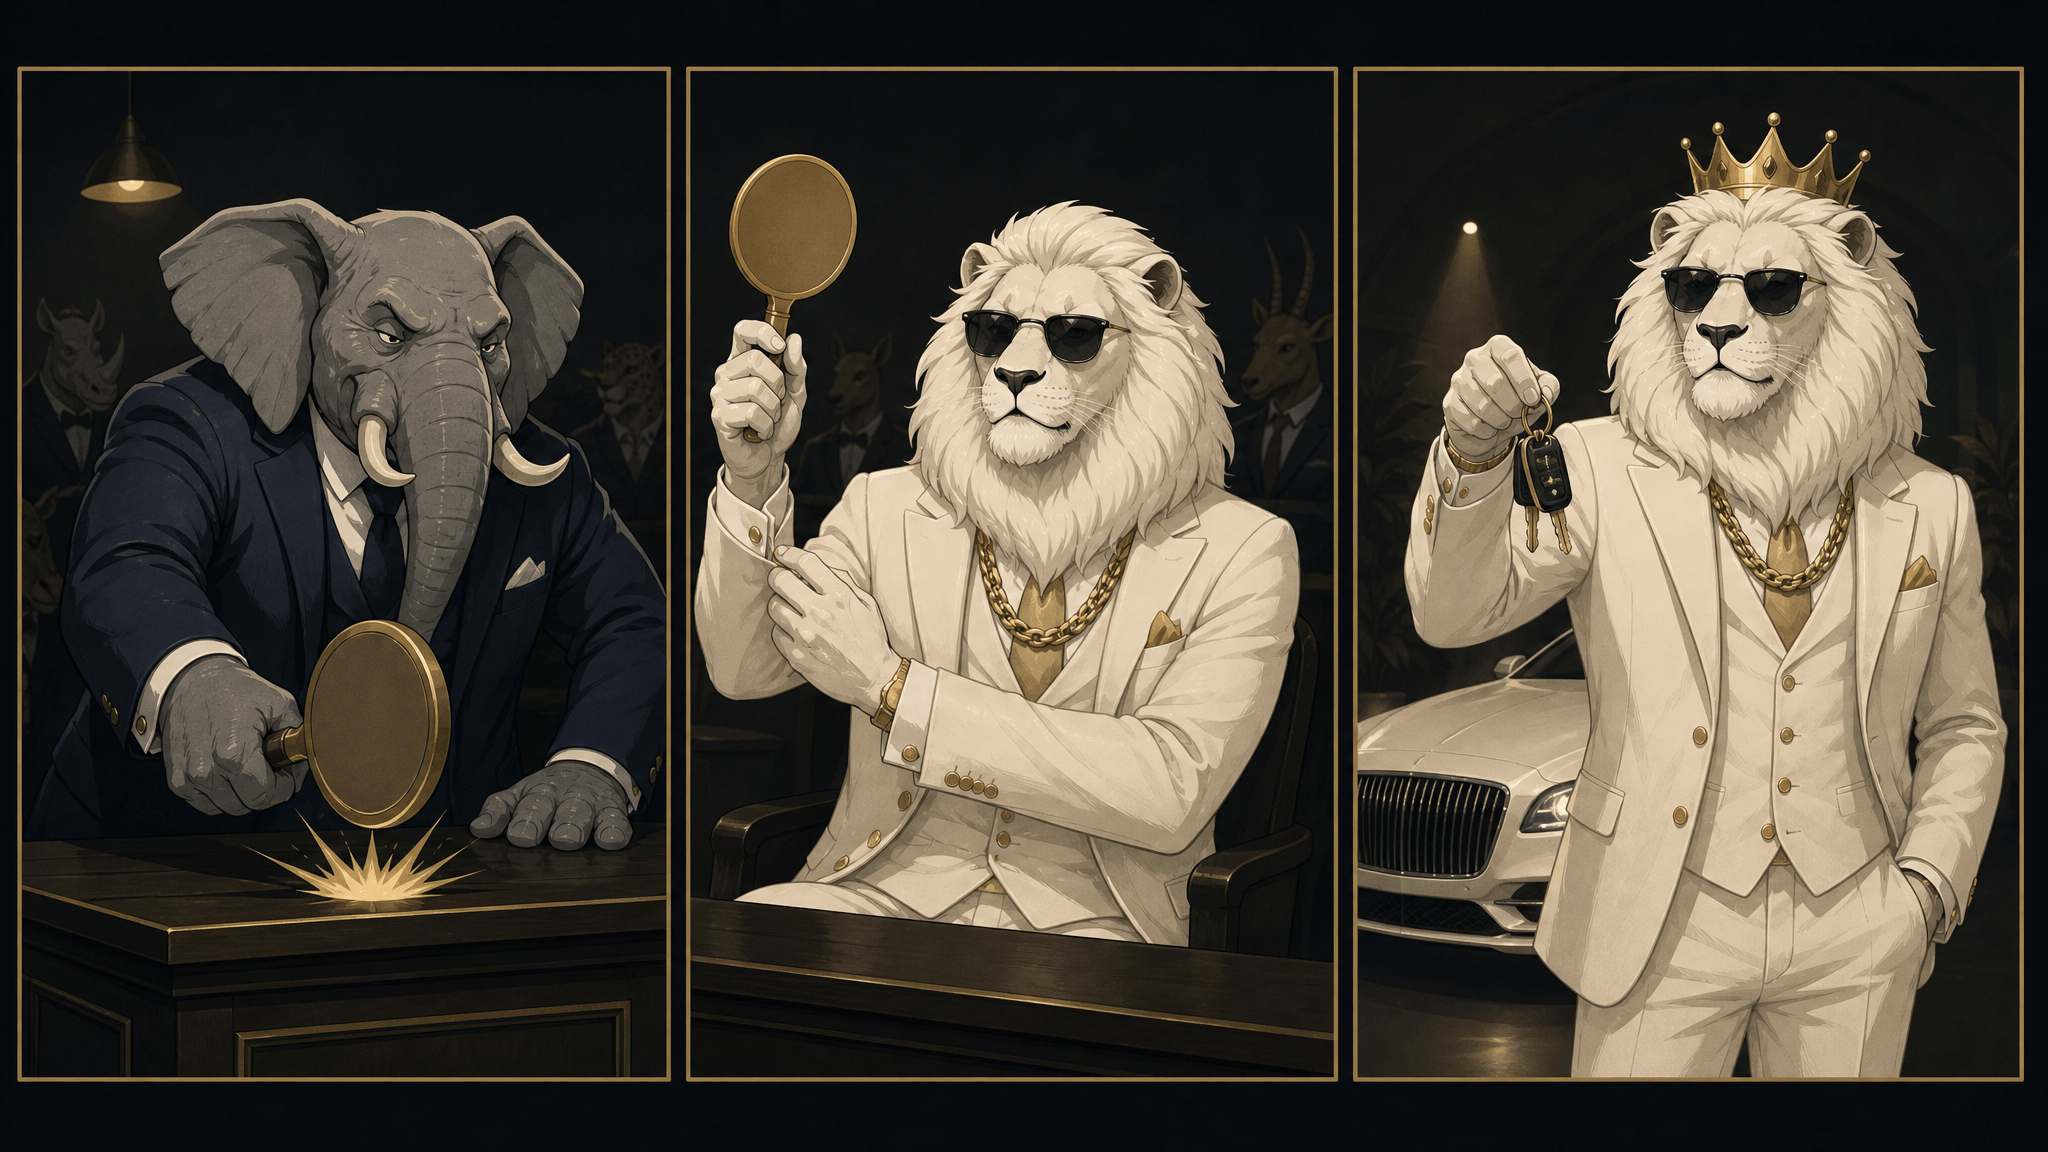
20–30 秒一段必须落下的三个节拍:对手报价、Sheru 反压、奖品到手。
送进哪个模型,决定了这套 Prompt 有多少能活下来。Seedance 2.5 是当前英文教程里点名的模型:Kapwing 的演示在 Kai 里选中它,之后再回到编辑器把六段拼起来;另一支 Zero to AI 的教程讲的是同一套搭配(Zero to AI,2026-11-11)。按 AI Fruit 的 Seedance 2.5 模型页,它接受文本或图片输入,单次可出 4–30 秒并带同步音频,支持首尾帧控制。
「每段限制」既是接力存在的原因,也说明接力只是一种选择。想要两三个明确的节拍、硬切、笑点精确落在某一帧,就生成 10 秒片段再串起来——衔接句加上编辑器里的首尾帧对齐,是不让它们漂走的关键。如果愿意用节拍控制换更少的接缝,就一口气生成整段 20–30 秒,台词当成一次说完——你对包袱落点的掌控会变少,但没有任何东西需要拼接。
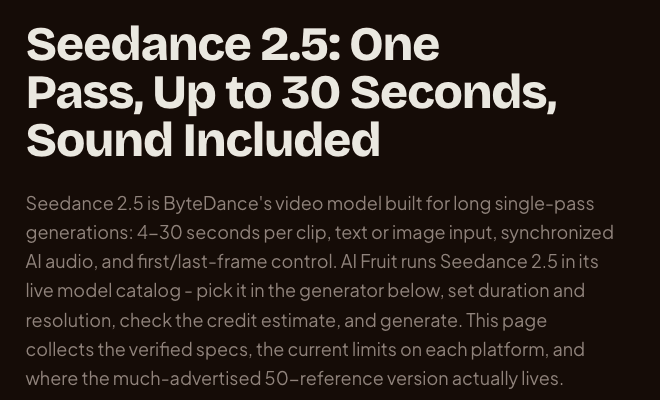
AI Fruit 的 Seedance 2.5 页面,截于 2026-11-16:本文提示词围绕的时长与画幅上限就来自这里。
哪里会崩,以及对应的那句 Prompt
| 症状 | 常见原因 | 修法 |
|---|---|---|
| 第 2 段里狮子换了只 | 只靠文字描述角色,没附参考图 | 每次生成都附角色参考图,重复身份句 |
| 每个镜头都在新房间 | 没有环境参考图 | 生成环境参考图并附上 |
| 六根手指、两条尾巴、拍卖槌浮空 | 一个镜头里塞太多动作 | 一段只写一个动作,把多余肢体写进 avoid |
| 第一秒是静音 | 模型习惯先留一拍再开口 | 写明「台词在 0.5 秒内开始」 |
| 台词被截断或糊掉 | 时长内的词太多 | 压到每 10 秒 14–18 个词 |
| 结尾莫名其妙抖个包袱 | 没有交代落点 | 写明「最后 4 秒享受刚赢下的奖品」 |
| 凭空冒出字幕和 logo | 模型自己发明屏幕文字 | 加「no on-screen text, no logos, no watermark」 |
还有两条不在 Prompt 里,在设置里:用 16:9 生成再裁成竖屏,会把头或奖品裁掉;时长超过模型支持的上限,会被静默截断。画幅设成 9:16,时长设成你真正计划好的片段长度。
没人拍的剪辑那一步
把片段拼起来,是节奏被打磨的地方——Kapwing 的演示最后落在编辑器里,原因就在这:发音、音量、停顿,生成后再修都比重新调 Prompt 快。三条检查:每段的最后一帧要对上下段的第一帧;报价台词要在配乐里听得清;台词里说的奖品,就是画面里正在领的那个。
水果版改写:同一套东西,换个角色
三层里没有任何一层是狮子专属。这套东西是「角色锁定 + 节拍结构 + 运动 Prompt」,而角色是唯一一个可以换掉、又不必重写方法的变量。换个物种,语法不动:一只穿米色西装的芒果大佬、一个西瓜对手、一位榴莲拍卖师,同样的拍卖槌,同样的最后四秒落点。
角色参考图改成这样:
Character reference sheet: one photoreal anthropomorphic mango
character, "Aam Bhai": glossy ripe mango body with a leaf stem, expressive
eyes, tailored cream three-piece suit, white shirt, deep-red tie, thick
gold curb chain, brushed-gold watch, black sunglasses. Confident posture,
upright human stance.

Four views on one neutral background: front, three-quarter, side, back,
identical outfit and lighting in all four. Photorealistic, 8k detail, no
text, no logos, no watermark.
然后把第二层母 Prompt 里的对手名单换成水果角色,第三层骨架里的地点换成水果市场或镀铬展厅。你在词数预算、静音开口和连续性上学到的东西,全部继续有效。
在 AI Fruit里,这就是一页的事:把运动 Prompt 贴进视频生成器,把角色参考图作为参考图片上传,选模型,设 9:16,生成前先确认时长和积分预估。与其相信一篇抄来的模型清单,不如直接打开选择器自己看:截至 2026-11-16,生成器默认停在 Grok Imagine Video,模型目录里还有 Veo、Kling、Wan、Seedance 2.0 和 Seedance 2.5,足够你测哪一版最稳地守住自己的角色,而不是被一个供应商绑住。想要更多水果场景的提示词写法,Seed 2.1 Pro 提示词合集覆盖的是另一个模型和另一批场景。如果你想跳过这三层的拼装,AI Sheru 视频页有五段为该页面生成的水果狮子短片,每段都印出所用的完整提示词——点「使用这些设置」就能加载进编辑器,生成按钮上还会先显示积分费用(默认 6 秒 720p 为 18 积分)。
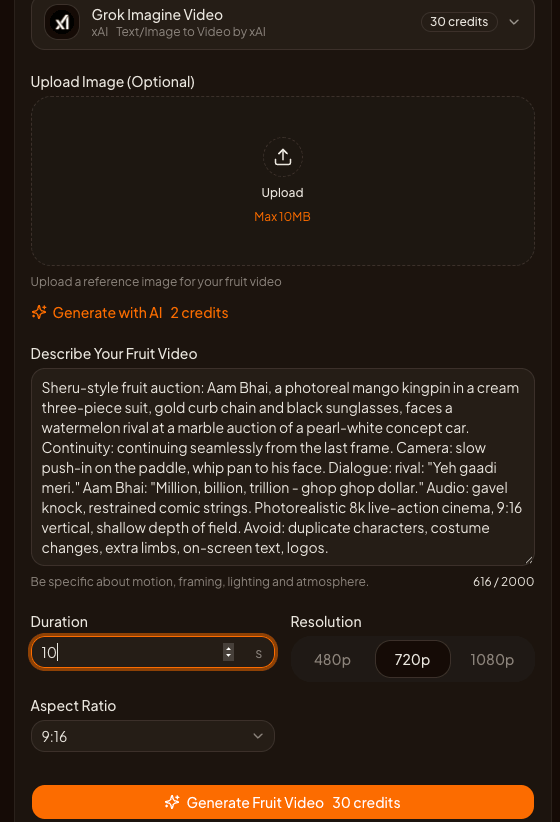
第三层 Prompt 贴进 AI Fruit 生成器:10 秒片段、9:16、生成前就能看到积分预估(截于 2026-11-16)。
版权、数据,以及这篇回答不了的事
发之前有三条限制值得直说:
- 角色是粉丝作品。 @digitalsheru 自称 Sheru 的源头。把别人塑造的角色用在变现内容里属于版权问题,本文不回答这个问题;如果这层风险对你的账号重要,就照同一套配方做一个自己的角色。
- 热度数据每天都在动。 上面那些日期,以及它们所依据的趋势曲线,是引用来源在 2026-11-14 和 2026-11-15 发布的内容。要围绕它做一个系列,先重新查一遍。
- 不保证质量和播放。 这些 Prompt 来自成文的工作流,不是实测结果。生成耗时、音频质量、口型、模型守住同一张脸的程度,都随模型、设置和队列变化。
用一段话收束
用参考图锁住角色,用一段声明总时长、再把时长切成镜头的母 Prompt 规划故事,然后给每个镜头一段自己的运动 Prompt——附上参考图、用你想要的语言写台词、加上一句从上帧起手的衔接。节奏在剪辑里修。如果你宁愿从水果角色开始而不是狮子,AI Fruit 生成器跑的是同一套「参考图 + 运动 Prompt」流程,模型、时长和积分成本都在你花掉任何东西之前显示出来。