
Gemini Agentic 视频理解:短视频创作者的实用工作流指南
Google 的 agentic 视频理解让长视频分析的 token 最多省 88%、成本最多降 66%;Qwen3.8-Omni-Flash 又把音频输入每小时价格砍掉超 98%、音视频超 93%。它改变了什么、如何进入选材、粗剪与质检环节,以及今天怎么开启。
2026 年 9 月 1 日上线的 Google agentic 视频理解,改写了"让 AI 认真看片"的成本:在标准视频分析基准上,启用该功能的 Gemini 模型最多可省 88% 的 token 消耗、降 66% 的分析成本,准确率还能提升最多 7%——而收益最大的场景,恰恰是创作者最头疼的长视频,从 10 分钟教程到数小时的完整录制。
如果你做短视频,这不是又一条生成模型的新闻:它产不出一帧画面。Agentic 视频理解做的是分析——找片段、查内容、回答"视频里发生了什么"——而这类分析的经济模型刚刚被改写了一个数量级。本文讲清楚底层到底变了什么,诚实地解读官方数字,把每项已发布的能力对应到短视频工作流的选材、粗剪和质检环节,并演示今天如何开启。2026 年 9 月 19 日更新:补入第二个数据点——新发布的 Qwen3.8-Omni-Flash 把音频输入每小时价格砍掉超 98%、音视频输入砍掉超 93%。成本塌陷不再是一家的事,而是两个厂商共同的方向。
静态处理 vs. agentic:到底变了什么
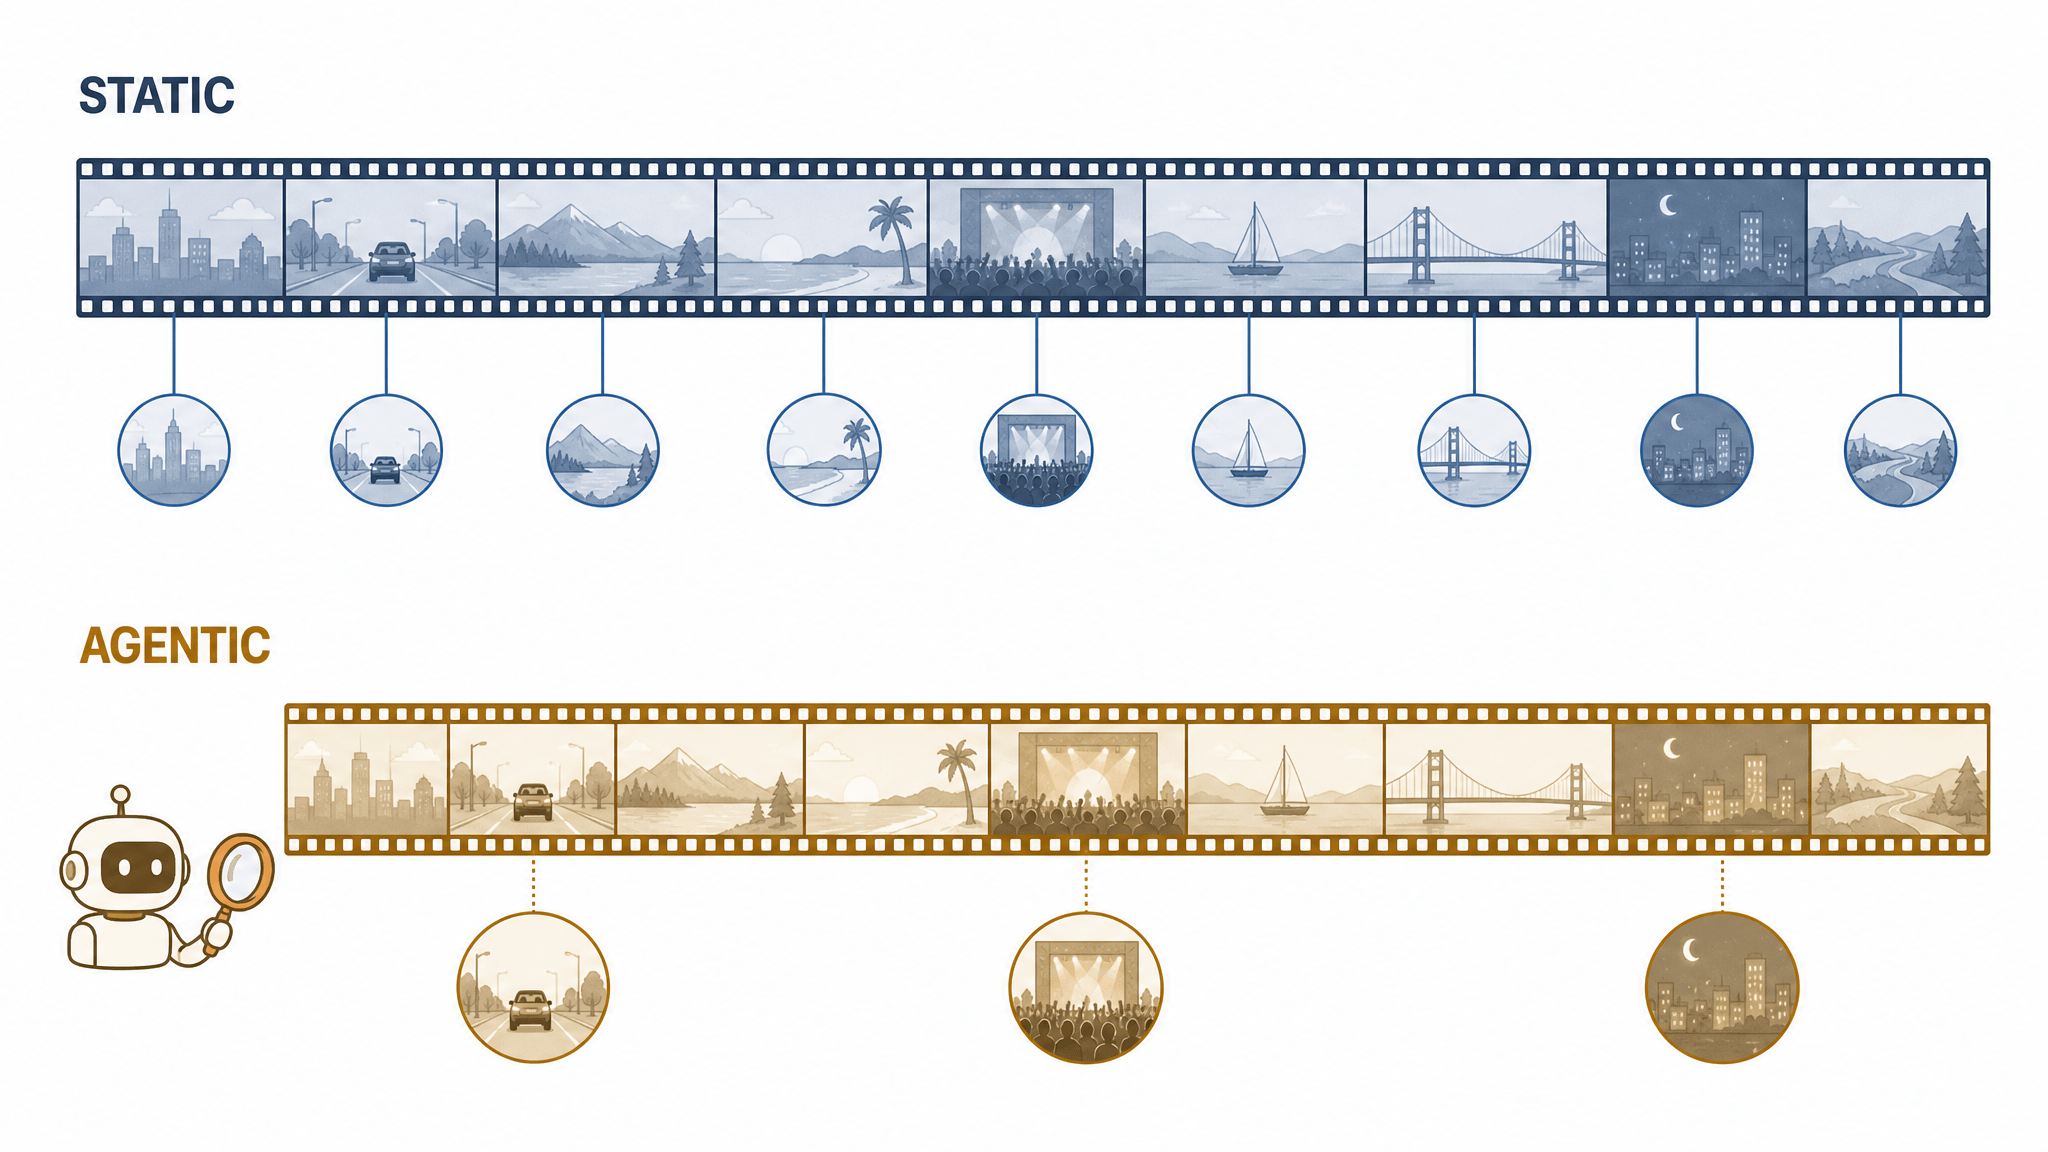
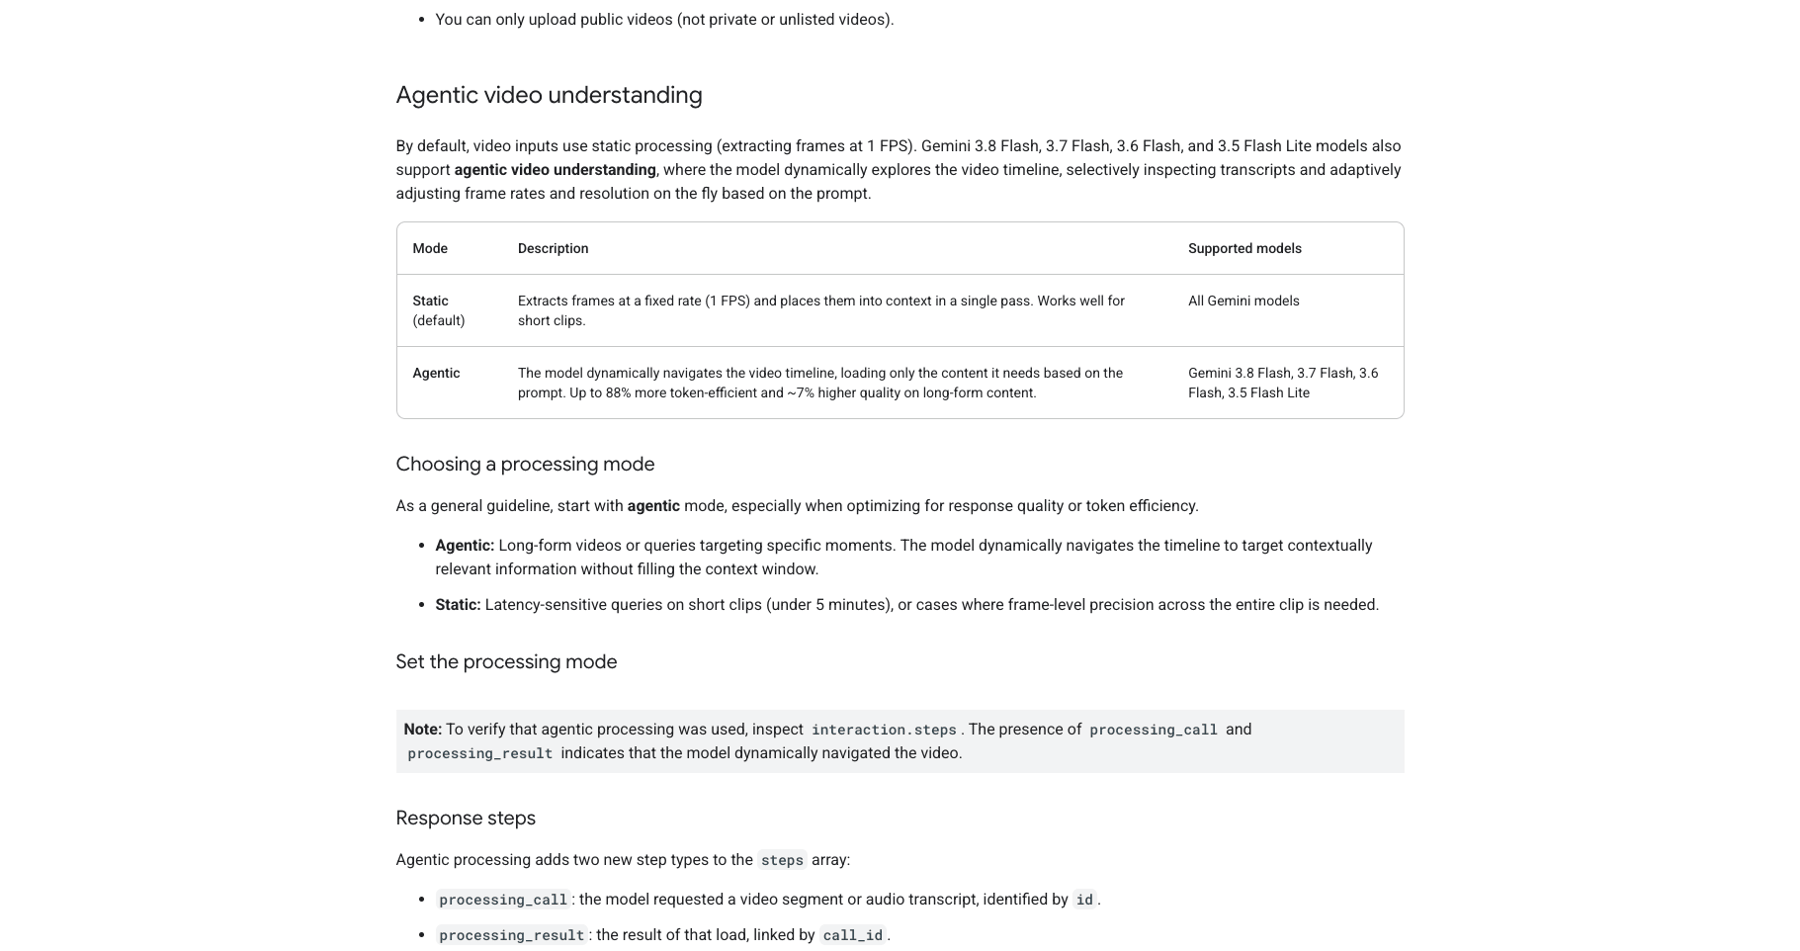
在此之前,Gemini 处理视频一直是静态方式:模型按固定帧率(默认 1 FPS)抽帧,一次性装进上下文。视频每一秒的成本几乎一样,不管这一秒里是你要找的瞬间,还是四十秒的废话。
Agentic 视频理解把这件事反过来:模型不再一次性匀速过完全片,而是主动、有目标地决定看什么、用什么速度看、通过哪种模态看——画面帧、音频还是转写文本。它通过一个 agentic 循环在视频时间线上导航,调用内部工具,只加载与你的问题相关的片段和信号。Google 把它称作 agentic vision 的视频版——后者让代码执行与 Gemini 原生图像理解配合工作。
| 静态处理(默认) | Agentic 处理 | |
|---|---|---|
| 如何读视频 | 固定帧率(默认 1 FPS),一次装进上下文 | 在时间线上动态导航,只加载需要的片段 |
| 使用的信号 | 按采样结果使用画面帧 | 画面帧、音频、转写文本,按问题选择 |
| 最适合 | 短片段;对延迟敏感的查询 | 长视频;针对特定时刻的查询 |
| 支持模型 | 所有 Gemini 模型 | Gemini 3.8 Flash、3.7 Flash、3.6 Flash、3.5 Flash Lite |
发布时覆盖 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite;Google 目前的开发者文档也已把更新的 3.8 Flash 列为支持。
诚实地解读这些数字
Google 公告里的每个效率数字都是"最多"值,而且是 Google 在标准视频分析基准上自己报的——把它们当上限看,不要当承诺。三项声明分别是:
-
Token 消耗:最多降 88%。模型不再为没人需要的帧付费。
-
分析成本:最多降 66%。token 更少,按标准 Gemini API token 定价,没有单独的功能费。
-
准确率:最多升 7%。选择性注意不只省钱;在长视频上模型答得更准,原因大概是上下文里不再塞满无效帧。
两个限定条件值得注意。第一,Google 明确说收益在长视频上最明显——10 分钟教程、90 分钟讲座、数小时录制——静态处理在这里曾让开发者只能二选一:要么高 token 账单,要么丢细节。30 秒的短片收益小得多。第二,Google 说启用 agentic 理解的 Gemini 3.7 Flash 位于其测试模型中视频分析准确率-成本的前沿(pareto frontier),长视频对比基于 LongVideoBench 基准。这是"在已测模型中"的声明,不是对一切工具的优势声明。
来源:Google DeepMind 博客 “Introducing agentic video understanding with Gemini”(2026 年 9 月 1 日)
十八天后:Qwen 让降价成为趋势
9 月 18 日,Qwen 发布新一代原生全模态模型 Qwen3.8-Omni-Flash:支持文本、图像、音频和视频输入,上下文窗口达 1M token。对创作者来说,头条不是评测表,而是价格行。据 Qwen 官方博客,相比上一代 Qwen3.5-Omni-Plus,API 每小时音频输入价格降幅超过 98%,每小时音视频输入价格降幅超过 93%。Qwen 同时给出在 29 项评测中对上一代平均提升超 25% 的成绩——说明降价不是靠砍能力。
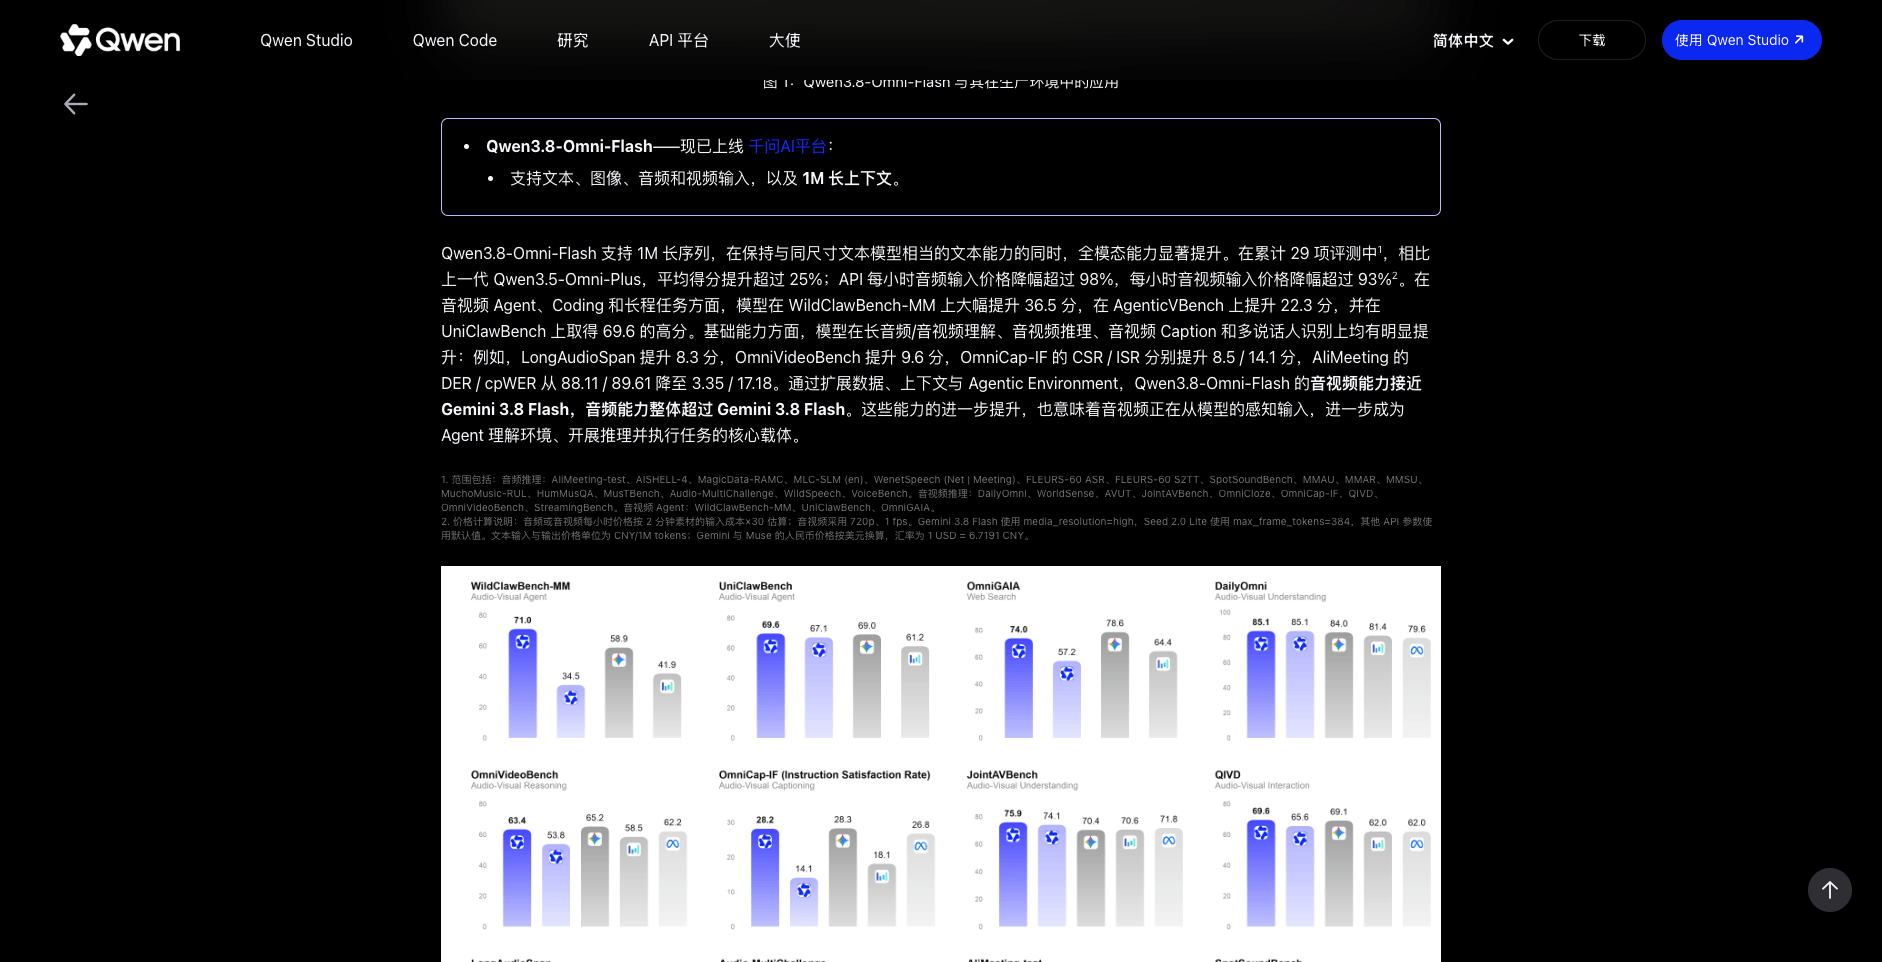
来源:Qwen 官方博客《Qwen3.8-Omni-Flash:耳聪目明,办事得力》(2026 年 9 月 18 日);价格数字为 Qwen 自报对比口径
细读脚注——Qwen 把方法论公开了,这点值得肯定。这些每小时价格是 Qwen 自己的估算:按 2 分钟素材的输入成本乘以 30 计,音视频按 720p、1 fps 计算,Gemini 3.8 Flash 按 media_resolution=high 对比,以人民币计价、美元按固定汇率换算。它们是 Qwen 方法论下的方向性对比,不是你账单上的数字。即便打完这个折扣,数字的形状本身就是新闻:音频和视频输入正在走向文本级别的经济模型——与 Google agentic 数字指向同一方向。
Agentic 模式带来的 token 经济学在 Qwen 这边同样成立。在 Qwen 的 OmniVideoBench 对比中,从静态处理切换到 agentic 处理(以 Qwen Code 作为 agent harness),准确率从 63.4 升到 67.8,每次查询的 token 从 145,736 降到 79,117——约省 45.7%,厂商自报。Qwen 还声称其音视频能力已接近 Gemini 3.8 Flash、音频能力整体超过后者。把它当作一家厂商的基准定位来看——与 Google 的声明发布在同一个月——但方向值得关注。
产品化路径的差异,创作者体感最明显。Google 的功能藏在 Gemini API 和 AI Studio 之后;Qwen 则发布了开源的 Qwen-MM-Plugins,能装进许多创作者已经打开着的 agent harness——Claude Code、Qwen Code、Codex——官方文档里的工作流读起来就像创作者的任务清单:按歌曲结构与歌词生成 MV、带角色克隆配音的短剧翻译、长电影解说制作、把数小时视频压缩成笔记。还有面向实时音视频交互的 Realtime 版本。下一节的蓝图,现在有两家厂商的管线可以落地。
它在短视频工作流里的位置
落到实操。Google 发布了四项能力,每一项都对应创作者流水线上的一个环节。由于该功能目前面向开发者,把这些当作工作流蓝图——你现在可以(通过 API 或工具)搭建的东西,而不是 App 里已经有的按钮。
1. 找片段:流水线规模的选材
大海捞针能力可以在数小时的视频上回答复杂查询,按 Google 的说法"不需要消耗数百万 token"。对创作者,这就是选材问题:两小时直播、播客录制或 vlog 素材里,哪六十秒值得做成一条 Short?
蓝图:把完整录制喂给 agentic 处理,按 brief 要带时间戳的候选片段——"情绪反应强烈的瞬间""产品演示真正奏效的三次""嘉宾前后矛盾的段落"。由于模型自己决定采样,成本跟着问题走,不跟视频时长走。亚秒级时刻检索再负责收尾:它能在 1 FPS 采样根本看不见的快速状态变化处,定位精确的剪切边界。
2. 粗剪支持:结构与计数
静态处理搞不定物理动作——1 FPS 下,快速运动只是两帧之间的一团模糊。Agentic 处理通过以动作需要的帧率反复回看片段,能准确计数重复动作和不同物体,还能从素材中拉出结构:钩子落在哪里、演示从哪里开始、每个节拍多长。
蓝图:要一份剪辑清单——每个节拍的时间戳、计数结果、片段时长——交给你的剪辑师或自动化组装步骤。模型出骨架,创意判断仍然归你。
3. 质检环节:异常检测
发布之前,同一能力会以更高帧率重新采样可疑时间窗,检查快速运动和细微视觉瑕疵。对 AI 生成的素材,这正好用来抓那些让片子被当成假货的失败模式:手势中扭曲的手、复制的物体、帧间晃动的文字。
蓝图:一个终检 prompt 扫全片、带时间戳报告异常——便宜到可以每条视频都跑,因为模型只在"看起来不对"的地方停留。
必须说明的局限
这些是文档化的能力,不是我替你跑过的教程。今天这个功能在 Gemini API 里——Google AI Studio 和 Gemini Enterprise Agent Platform——要落地任何蓝图,都得直接走 API 或通过封装工具。Qwen 的路径已经产品化成另一种形态:开源的 Qwen-MM-Plugins 把视频理解装进上文那些 agent harness,从蓝图到能跑的脚本,路更短。Google 说该功能将很快向 Gemini App 全量用户开放(Flash 与 Flash-Lite 系列),并在未来几个月驱动 YouTube 的"Ask YouTube"观看页功能。方向已经清楚:视频理解正在变成一层便宜的标准能力——而创作者工具是它最自然的落点。
如何开启
开启方式刻意朴素:在视频输入上把 processing 设为"agentic"。开发者指南 用几行代码演示:
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.7-flash",  # 3.8 Flash, 3.6 Flash and 3.5 Flash-Lite also supported
    input=[
        {
            "type": "video",
            "uri": "https://youtu.be/7Z5Vy9JBANs",
            "processing": "agentic",
        },
        {
            "type": "text",
            "text": "What are the 3 most important announcements in this keynote?",
        },
    ],
)
print(interaction.output_text)
文档中的实用提示:
-
验证:想确认模型真的走了 agentic,检查 interaction.steps——出现 processing_call 和 processing_result 条目,说明模型在动态导航视频。
-
模式选择:Google 自己的建议是,优化质量或 token 效率时先试 agentic;5 分钟以内的延迟敏感查询、或需要对整个短片段做帧级精确分析时,保留静态。
-
混合模式:一个请求可以同时用两种——两小时的讲座用 agentic,同一段 prompt 里 20 秒的短片用静态。
-
输入限制:File API 在付费档接受最大 20GB 的视频(免费 2GB),内联数据 100MB 以内,支持公开 YouTube 链接(私有或未列出视频会被拒绝)。Gemini 2.5 及之后的模型每个请求最多上传 10 个视频。
来源:Gemini API 文档 “Video understanding”(2026 年 9 月 3 日查阅)
它是什么——以及它不是什么
在围绕它重新规划你的一周之前,先把现实核对清楚:
-
它不生成视频。Agentic 视频理解做分析、检索、计数和检查。生成仍需要专门的视频模型——即便 Google 自家的 Gemini Omni 在生成侧模糊了边界,这一点也没变。
-
数字是厂商自报的。−88%/−66%/+7% 出自 Google 自己的基准;>98%/>93% 的每小时降价出自 Qwen 自己的定价测算,且公开了方法论。LongVideoBench 这类基准是标准的,但独立验证需要时间——对两家都一样。
-
结果因情况而异。按 Google 自己的说法,模型行为取决于所选模型、设置和内容;长视频收益远大于短片段。
-
面向消费者的入口还在排期。Google:今天是 API 和 AI Studio,Gemini App "很快",Ask YouTube "未来几个月"。Qwen:平台 API 和开源插件今天可用;Realtime 版本面向实时交互,不是长素材的批量分析。
结论
Agentic 视频理解第一次让"让 AI 认真看长片"有了主流可承受的价格——它把创作者流水线里三个昂贵的手工环节(找片段、粗剪、质检)变成便宜、可脚本化的提问。两家厂商在十八天之内,把机器注意力的价格变成了一条下行的成本线。每个厂商数字都按方向性来读,但方向本身已经不需要再怀疑。按工作流而不是按单一工具思考的创作者,会在它落进常用 App 的那天准备好。
而当工作流指向另一个方向——你清楚知道要哪个瞬间、哪种 format,但需要的画面从未存在过——那就是生成问题。AI Fruit 从提示词、图片和模板生成短视频,模型选择与积分成本在你花费前清晰可见。理解告诉你做什么;生成把它做出来。