
FastH3 Omni 详解:把 MiniMax H3 蒸馏到 8 步——性能、用法与部署
FastH3 Omni 是什么、8 步蒸馏如何工作、官方延迟基准及其测试条件,以及 ComfyUI / FastVideo / UniServe 三条运行时的部署指南——附大多数报道略过的 license 细则。
FastH3 Omni 是 FastVideo 对 MiniMax H3 的开源蒸馏版本,2026 年 10 月 20 日发布。给它一段提示词,外加几张图片、几段视频或音频参考,它就能生成一条带同步立体声的完整短片——只用了八次 transformer 评估,而基础模型需要五十次。官方基准显示,在数据中心 GPU 上端到端延迟降低 5.6–11.9 倍;量化后的 checkpoint 还能跑在单张 RTX 5090 或一台 DGX Spark 上。
这篇指南整理了模型能做什么、蒸馏是怎么做的、基准数字到底测了什么,以及在三条受支持运行时上跑起来各需要什么。所有内容均来自官方发布文档和模型卡;我们自己没有实际运行过模型,凡依赖 FastVideo 自身测试条件的数字,都会注明。
FastH3 Omni 是什么
MiniMax 在 2026 年 8 月初发布了开源权重、全模态的生成系统 H3:文本、图片、视频、音频作为一个共享上下文输入,输出带原生 32 kHz 立体声的视频。它的 Ref2VA 模式最多接受九张图片、三段视频和三段音频——合计十二条参考——FastH3 Omni 原封不动地继承了这套输入约定。
FastH3 Omni 不是一个新的基础模型。它保留了 H3 的文本编码器(基于 Qwen3-VL-32B)、视频 VAE 和音频 VAE,只把扩散 transformer 换成了蒸馏出的「学生」模型,所需去噪步数大幅减少。在 FastH3 产品线上,更早的版本已经把基础 H3 的 50 步视频轨迹蒸馏到 8 步;Omni 则在这 8 步预算之上加上了完整的参考条件化路径。本次发布由 Nuva Lab 联合开发(负责 omni-reference 训练数据集的策展),Reactor 提供算力支持。
产出规格很具体:24 FPS、32 kHz 立体声、音画同步的视频,时长 5 / 10 / 15 秒(124 / 243 / 362 帧)。至少需要一个图像或视频参考——这是一个 reference-to-video 模型,不是纯文生视频。
八步如何取代五十步
这次发布组合了两种蒸馏技术,两者如何配合才是关键。
PDD——一次前向,多步更新。 Parallel Decoding Distillation(并行解码蒸馏)把学生的输出头从单一速度预测扩展成 32 个细时间格点的网格。推理时,这些头以八个融合块、每块四个的方式运行,一次 transformer 评估就让轨迹前进四个格点。八次评估走完基础 H3 五十次的路径。教师监督的损失保证每个头的更新与冻结的基础模型保持一致。
DMD——对齐最终成品。 在 PDD 之上,Distribution Matching Distillation(分布匹配蒸馏)训练一个 critic 来建模学生样本的分布,冻结的 H3 教师给出目标分布;学生在「完成的视频和音频」上缩小两者差距,而不是在单个去噪步骤上。训练时 critic 更新与学生更新交替进行。
两个配套选择对部署很重要。学生模型在 128 行分块(128-row tiles)的 Video Sparse Attention 上训练和采样,所以推理服务利用的稀疏性就是它学过的稀疏性。参考输入从不加噪——图片、视频、音频在每次前向中都作为学生、教师和 critic 的条件输入,这正是多条参考的身份特征能在生成全程保持稳定的原因。
训练成本:64 张 NVIDIA B300 GPU、3,500 步、约 7,800 GPU 小时。训练代码随 FastVideo 发布,如果你有自己的数据和硬件,可以复现整个配方。
实际有多快——以及这些数字的测量条件
FastVideo 在 27 组匹配工作负载上对比了 FastH3 Omni 与基础 H3:九种参考组合(从单张图片到九图加三段视频)乘以 5 / 10 / 15 秒三种时长,全部在八张 GB200 GPU 上完成。计时覆盖整条流水线——参考编码、生成、解码、成品 MP4——画布 1344×768,取三个随机种子的平均值。
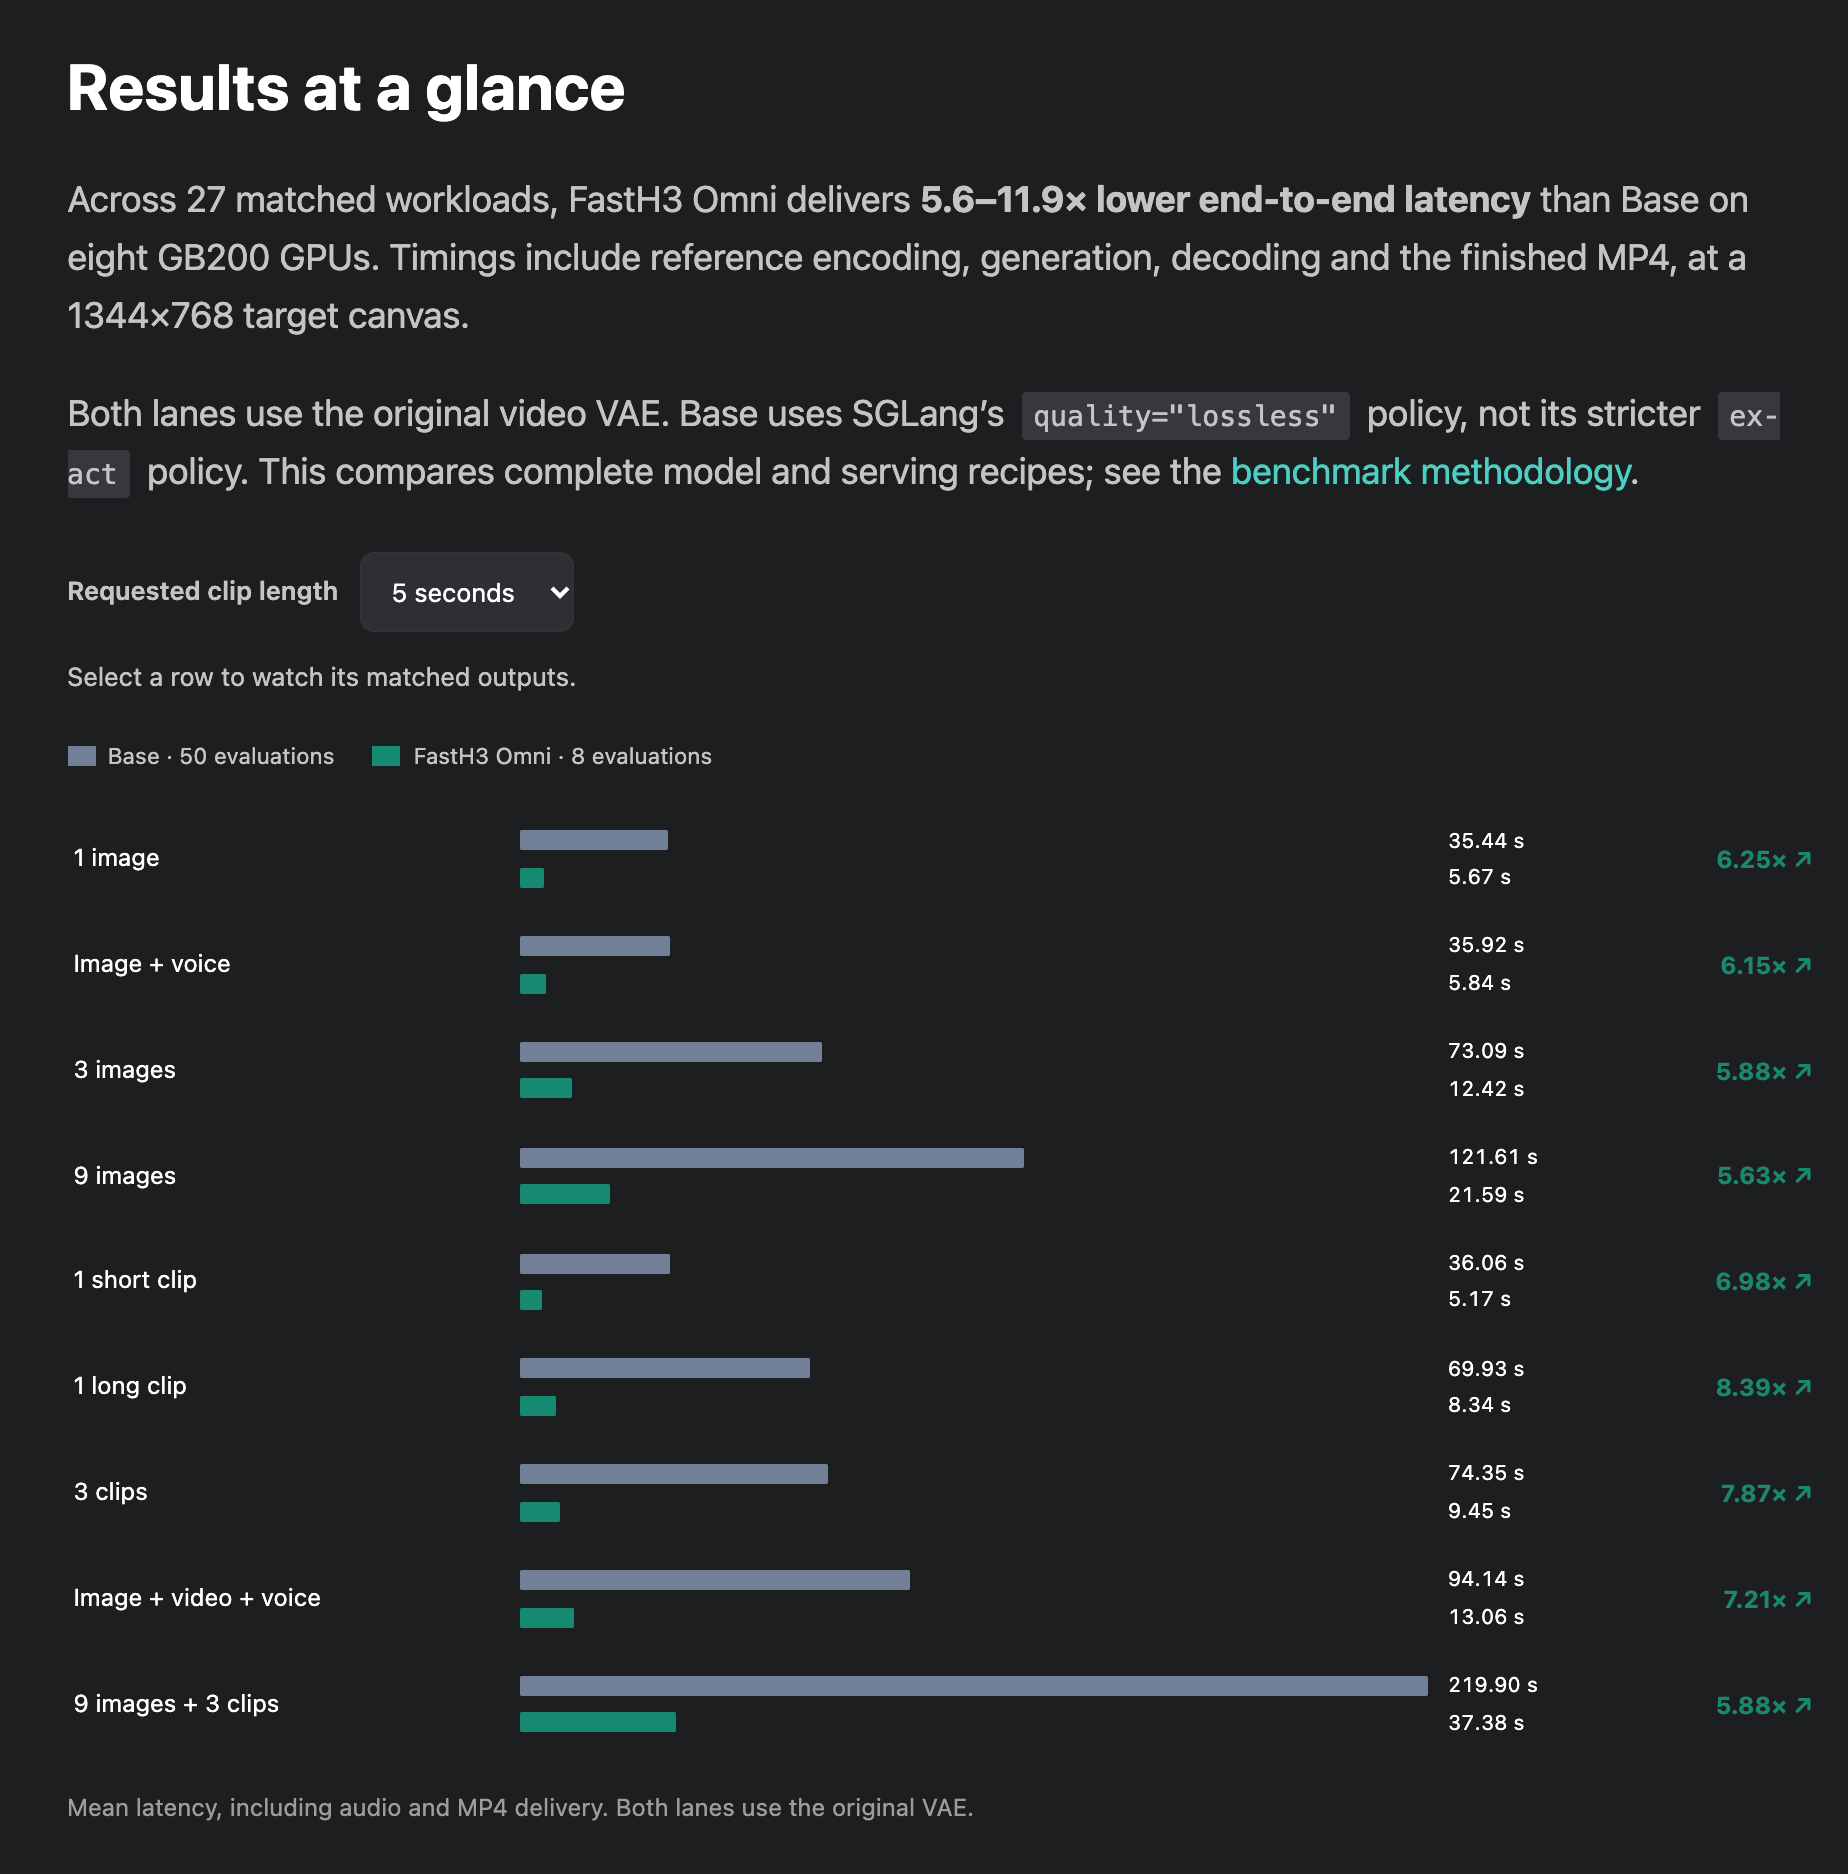
来源:FastVideo 发布博客(haoailab.com),2026-10-20——8× GB200 上 27 组匹配工作负载,三种子均值。
结论先行:全部 27 组工作负载端到端延迟降低 5.6–11.9 倍。几个代表性数据:
| 工作负载 | 基础 H3(50 步) | FastH3 Omni(8 步) | 提速 |
|---|---|---|---|
| 1 图,5 秒 | 35.44 秒 | 5.67 秒 | 6.25 倍 |
| 1 图,15 秒 | 139.69 秒 | 14.14 秒 | 9.88 倍 |
| 1 段短视频参考,15 秒 | 140.29 秒 | 11.76 秒 | 11.93 倍 |
| 9 图 + 3 段视频,15 秒 | 422.20 秒 | 59.77 秒 | 7.06 倍 |
读这些数字时,条件比倍数更值得琢磨。它们是八张 GB200 上的完整服务配置对比,基础 H3 使用无损数值策略。官方的说法是 UniServe 栈在特定 FastH3 Omni 任务上对 768p 的 5 / 10 / 15 秒片段达到实时生成——这是带条件的表述,不是普遍承诺。另外,官方放出的对比片段明确是「匹配条件下的定性比较」,并不证明蒸馏模型的输出质量与基础模型持平。独立的质量评测目前还不存在;早期的社区口碑听听就好。
跑起来:三条运行时,一次决策
FastH3 Omni 按运行时分发不同格式的 checkpoint,选对格式比选「最好的」更重要。
ComfyUI——消费级硬件上的可视化工作流
ComfyUI 路线需要四个组件放进 models/ 目录:
- 扩散模型:
fasth3_omniref_8step_pruned_bf16.safetensors(44.2 GB)或 INT8 ConvRot 版(22.2 GB,官方模板默认) - 文本编码器:基于 Qwen3-VL-32B,有 BF16(51.5 GB)、INT8(27.1 GB)、NVFP4 AWQ(15.7 GB,仅 Blackwell)三种
- 视频 VAE:BF16(5.2 GB)或 INT8(2.8 GB)
- 音频 VAE:fp32(0.6 GB)——必需,缺了就没有声音
官方工作流模板(video_fasth3_ominiref_r2v,10 月 20 日加入)按 8 步、guidance 1.0、视频 shift 12.0、音频 shift 3.0 运行,默认 1344×768、124 帧。提示词按位置引用输入——<Picture 1>、<Video 1>、<Audio 1>——模板还提供参考尺寸选择:match 把参考缩放到生成分辨率面积,max 保留 2048 像素短边以换取身份保真,代价是数倍算力。注意 ComfyUI 用自己的采样器和内核,输出可能与 FastVideo 和 UniServe 不一致。如果你想在 ComfyUI 里做 H3 多镜头项目,Director 插件生态提供了时间轴式分镜能力,我们在 MiniMax H3 Timeline in ComfyUI 一文中单独介绍过。
FastVideo 本地——DGX Spark 与 RTX 5090
单工作站场景下,FastVideo 运行 NVFP4 QAD 版本——通过量化感知蒸馏训练、为 Blackwell 硬件的 NVFP4 执行而生。两种设备配置默认输出 480p。DGX Spark(GB10,128 GB 统一内存)把模型组件常驻内存;RTX 5090(32 GB)则卸载文本编码器,并需要预计算的 AdaLN 表。可选的 NVFP4 VAE 解码器分 36 层质量档和 8 层快速档。
UniServe——生产级服务
服务化场景下,BF16 checkpoint 通过 UniServe 的 reference-conditioned(ref2va)配置运行在 GB200/B200、RTX PRO 6000 Blackwell 和 Hopper(含 H100/H200)上。官方示例部署了一个双节点 4+4 GPU 副本,可服务最长 15 秒的 768p 请求,同时驻留两个请求,通过一个简单的 REST 接口(/v1/videos/sync)对外提供生成。UniServe 指南覆盖安装、GPU 放置和请求容量。
RTX 4090 一类显卡
不支持 FP4 的硬件并没有被排除在外:FP8 权重是独立变体,官方提供 RTX 4090 配方(逐层 offload),搭配 BF16 文本编码器组件。注意其输出与 BF16、NVFP4 版本在数值上会有差异。
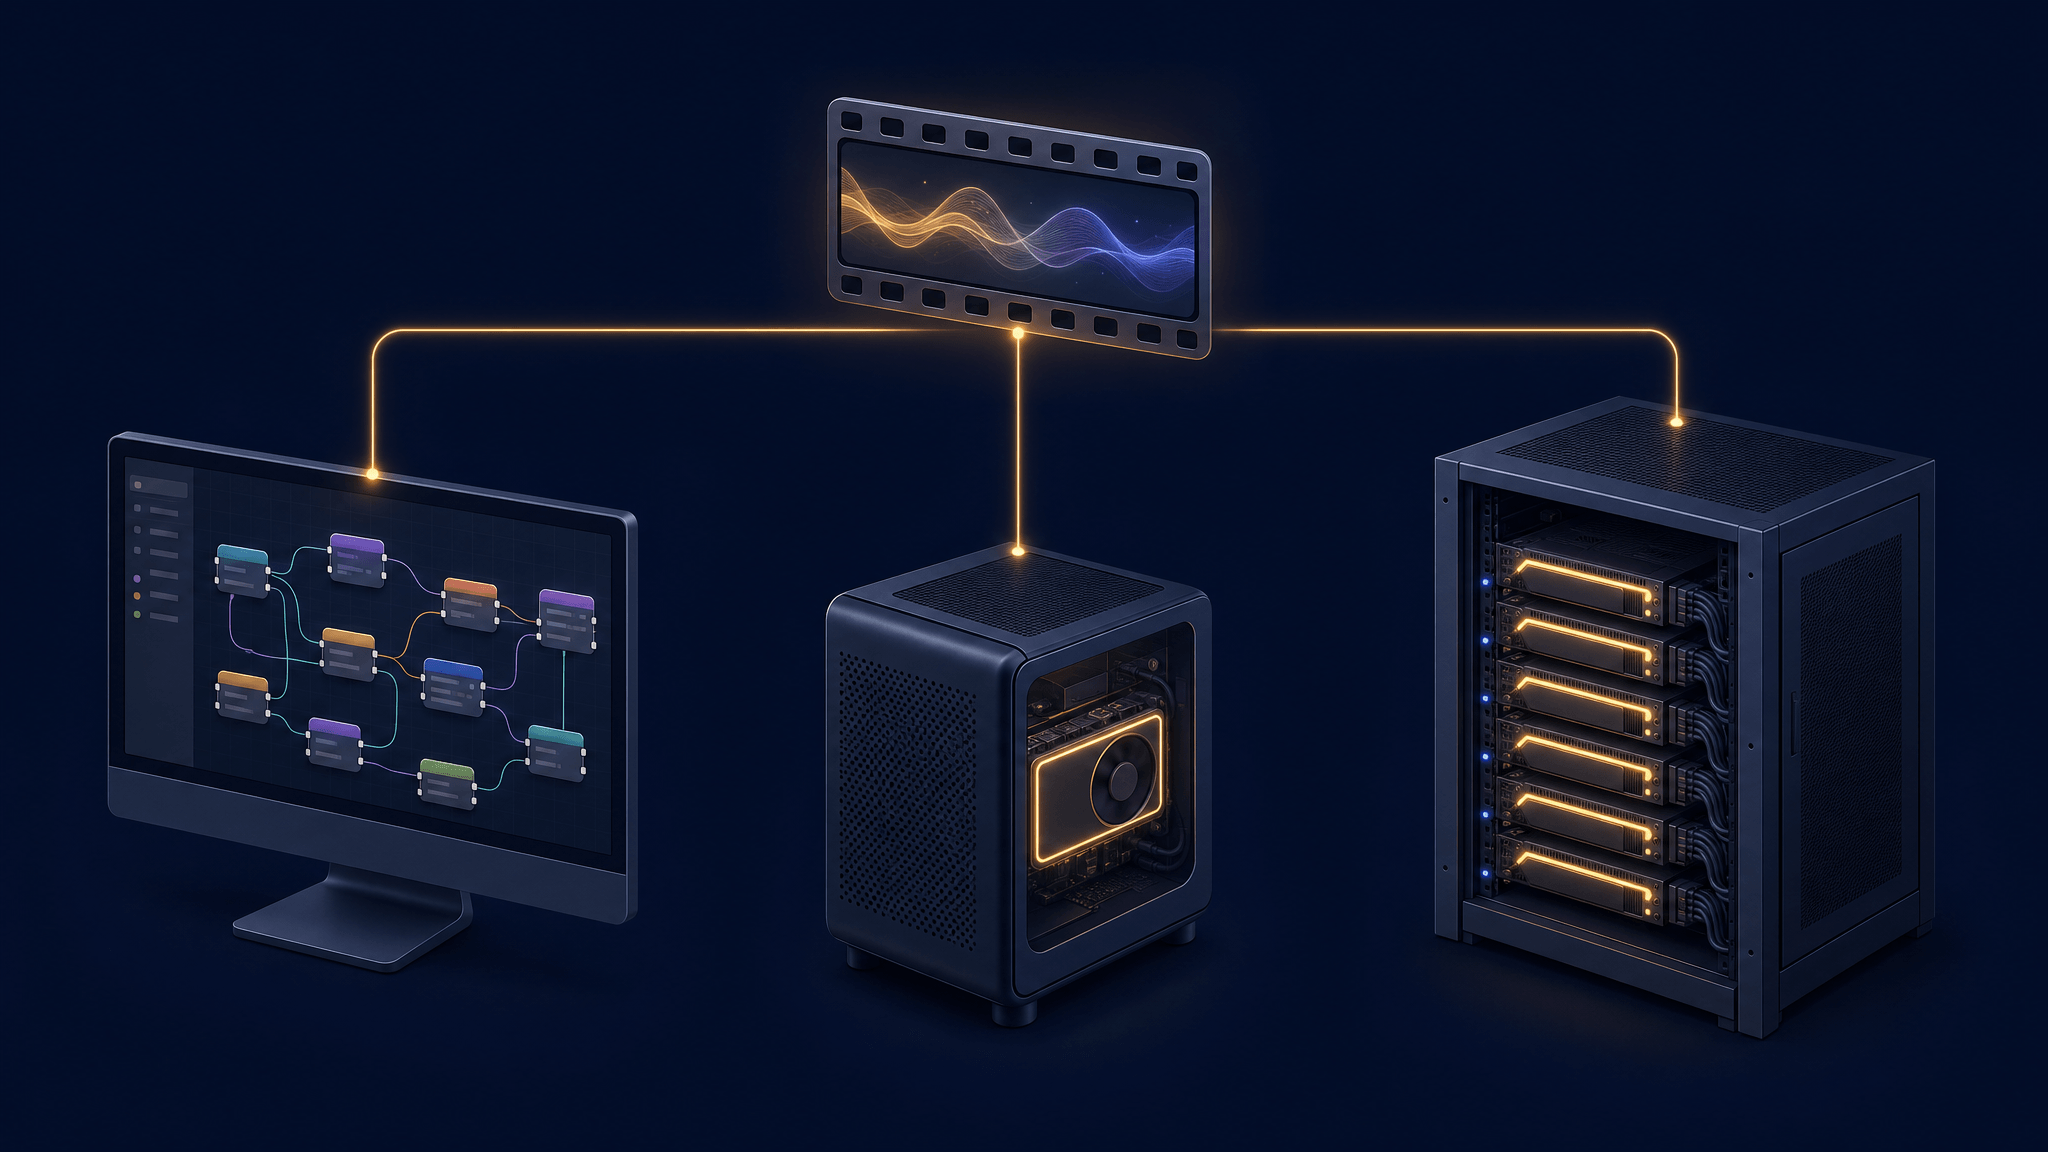
一句话决策:ComfyUI 适合实验和可视化控制,FastVideo 本地适合个人 480p 工作站,UniServe 适合多人 768p 服务——显卡不支持 FP4 就选 FP8/INT8。
多数报道略过的 license 细则
FastH3 Omni 的权重受 MiniMax H3 Community License Agreement 约束,其中三条会让不少人意外:
- 地域。 许可证的适用范围明确排除欧盟、英国、韩国和美国。在这些地区使用或分发需要向 MiniMax 另行取得许可。
- 规模。 基于该模型的商业产品或服务年收入超过 2,000 万美元时,需要事先获得 MiniMax 的书面授权。更小规模的商用是允许的——但许可证要求你在产品界面醒目标注「MiniMax H3」。
- 产出与衍生。 生成的视频不被视为模型衍生品——但不得用输出结果去训练或改进其他 AI 模型。
以上不构成法律意见,请根据自己的情况阅读协议原文。但如果你在评估把 FastH3 Omni 用于产品,单是地域条款就是大多数发布报道从不提的检查项。
没有硬件也想跑 H3?
关于部署的诚实结论是:自托管 FastH3 Omni 意味着接受巨大的下载量(仅 BF16 扩散模型就有 44 GB,还没算 27–51 GB 的文本编码器),而要实时服务 768p,还需要数据中心级 GPU。如果你有硬件、也需要本地控制权,这是个很有吸引力的包。
如果你真正想要的是「H3 水准的参考生视频」,而不是自己背运行它的包袱——它所蒸馏的基础模型已经可以在线使用:AI Fruit 在生成器中托管了 MiniMax H3,支持文生视频和图生视频、4–15 秒、768P/2K 输出,不需要你自己的 GPU。蒸馏版 Omni 不改变这条路线的成本;它主要改变的是自托管玩家能做什么。
结论
FastH3 Omni 对三类人有意义。ComfyUI 用户在消费级体量的原生工作流里得到了参考生视频带音频的能力;自托管玩家得到了一份在延迟上足以证明蒸馏价值的基准表;服务化建设者得到了带逐负载实测数据的生产路径。在动手之前,核对三件事:checkpoint 体积对上你的存储、license 条款对上你的地区,以及——等独立质量对比出现后——蒸馏后的输出是否经得起你的内容类型检验。