
Vidu S2 解读:实时 AI 数字人视频与直播流编辑,创作者该怎么用
Vidu S2 一次带来实时数字角色与视频流实时编辑两个模型。9 月 15 日的这次发布对短视频创作者意味着什么,三种工作流怎么落地,一文讲清。
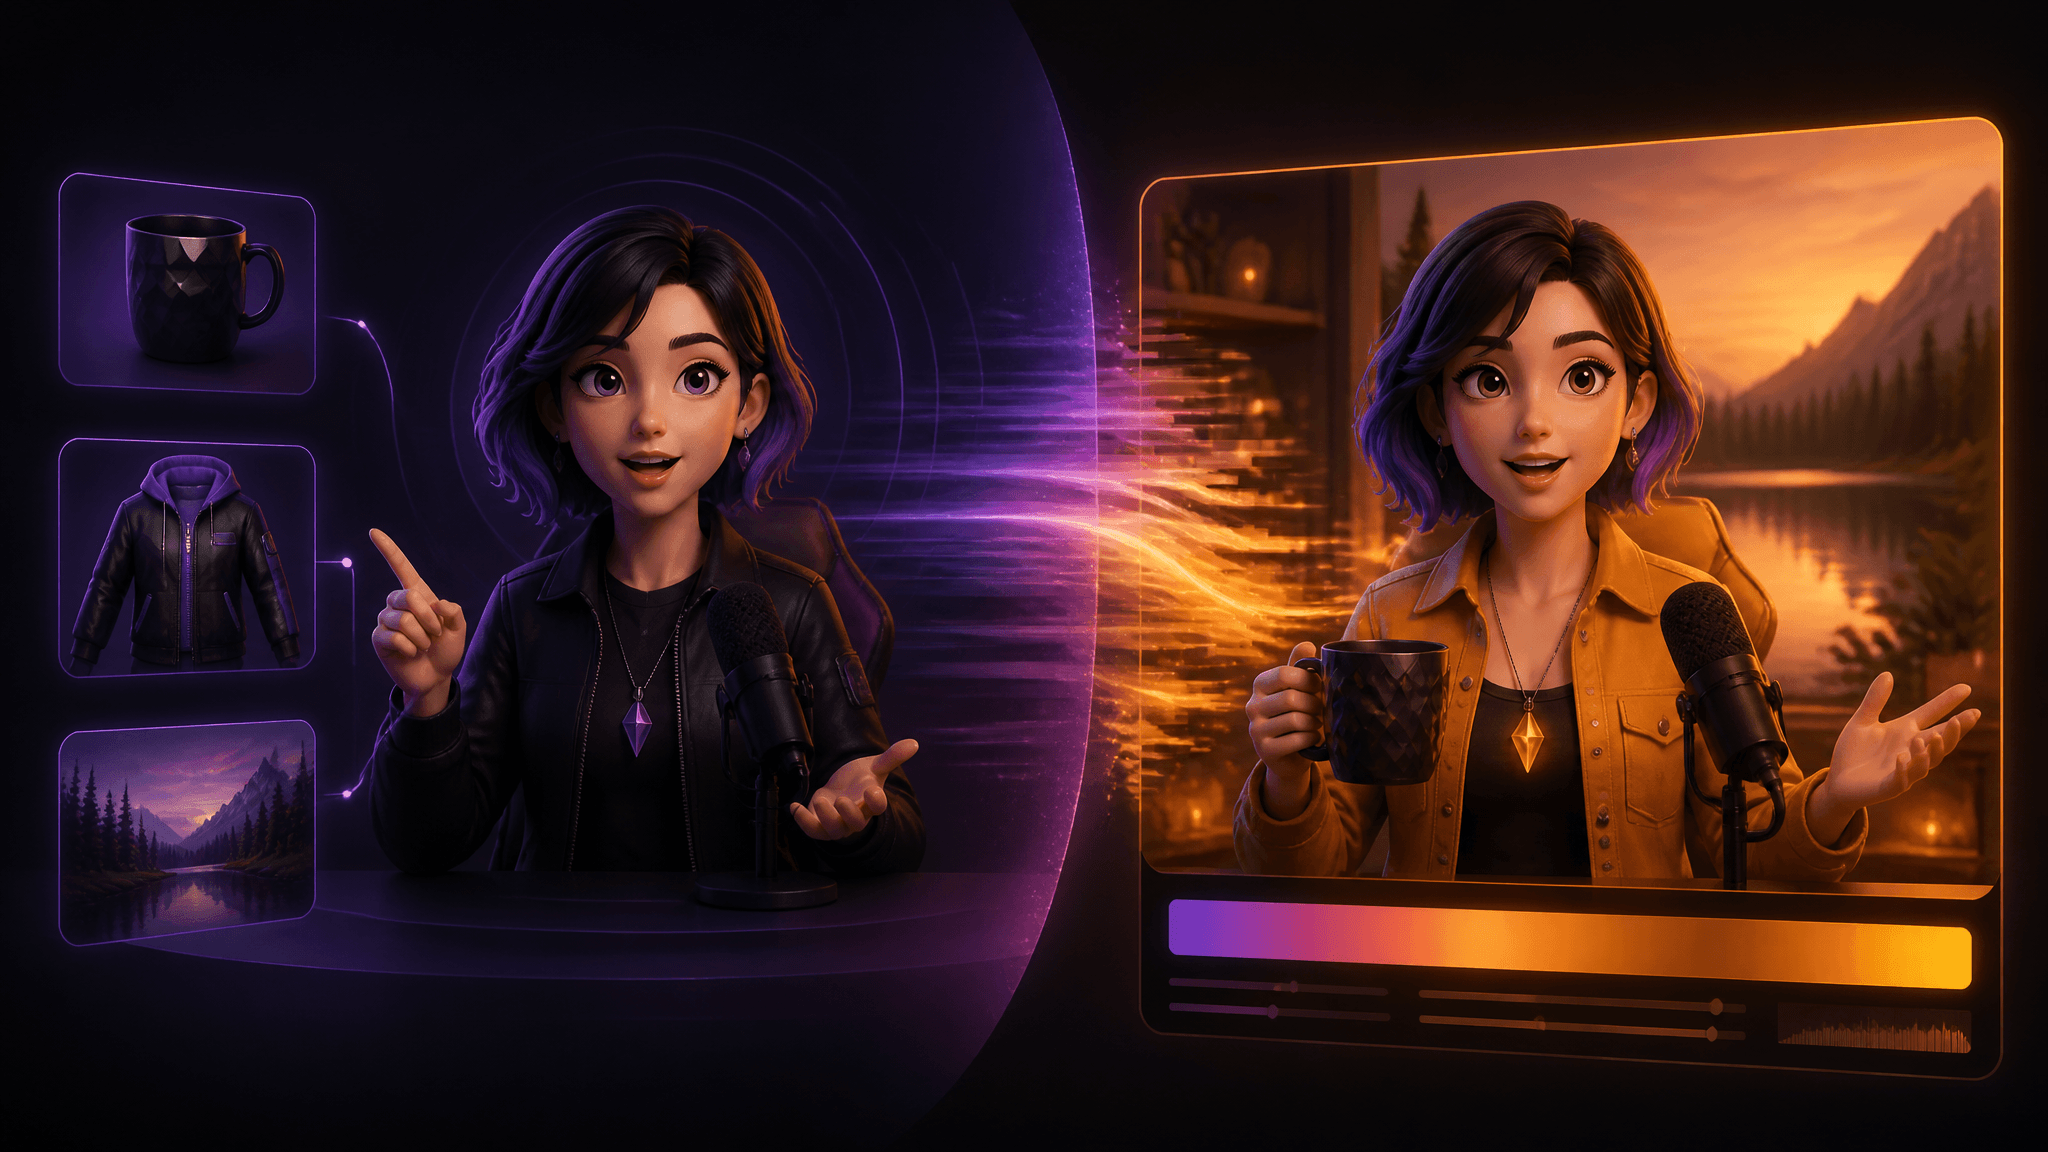
生数科技在 2026 年 9 月 15 日正式发布 Vidu S2,上线当天即向所有人开放——没有排队申请,也没有研究预览门槛。这次发布实际上是两个模型:Vidu S2-Avatar,一个可以边生成、边对话、边指挥的实时数字角色模型;以及 Vidu S2-Editing,一个能在视频流播放的同时进行实时编辑的模型。对短视频创作者来说,这个组合指向一种新的工作方式:让 AI 数字人视频在你说话、换参考图的过程中实时响应,让拍好的素材不改拍就能换风格追热点。
本文拆解两个模型各自能做什么,把它们映射到三种具体的短视频工作流,并区分哪些是已上线的能力、哪些还停留在实验室演示——VR 空间视频属于后者。先说清楚一个前提:本文所有内容都基于文档研究。我们没有实际运行过 Vidu S2,文中的性能数字全部来自官方技术报告。
要点速览
- Vidu S2 = 两个模型:S2-Avatar(实时交互数字角色)和 S2-Editing(输入视频流的实时编辑)。
- 据技术报告,S2-Avatar 将实时生成从 540p 提升到 720p,同时保持 25–42 FPS。
- 两个模型都支持在视频流中途更换参考图——换服装、换背景、换物品、换场景,无需重启。
- S2-Editing 覆盖四种实时操作:风格渲染、虚拟换衣、角色替换、背景替换。
- 基准测试成绩为官方自报;空间视频是探索性演示,不是消费级功能。
一次发布,两个模型
理解 Vidu S2 的关键在于它的结构。S2-Avatar 回答的是"我能不能有一个实时互动的数字角色";S2-Editing 回答的是"我能不能编辑还在录制的画面"。官方公告把两者描述为同一系统的两个入口,发布当天就可在 vidu.com/vidu-stream 体验。
| Vidu S2-Avatar | Vidu S2-Editing | |
|---|---|---|
| 输入 | 你的语音/文字 + 一张角色图,交互中可随时注入参考图 | 持续输入的视频流——摄像头、视频文件或静态图片 |
| 输出 | 实时对话、动作、反应的数字角色(报告称 720p) | 同一路视频流,边播放边被重新编辑 |
| 创作者用途 | 直播类数字人内容、可交互角色 | 不重拍就能翻新、多平台复用素材 |
这个区分很重要,因为此类别的"实时"发布通常只做其中一件事——要么是可交互的角色演示,要么是渲染很快的离线编辑器。S2 把两边都当成了流式问题。作为背景:上一代 Vidu S1 的实时输出止步 540p,且角色形态基本局限于说话头像类。
S2-Avatar:一个可以实时指挥的数字角色
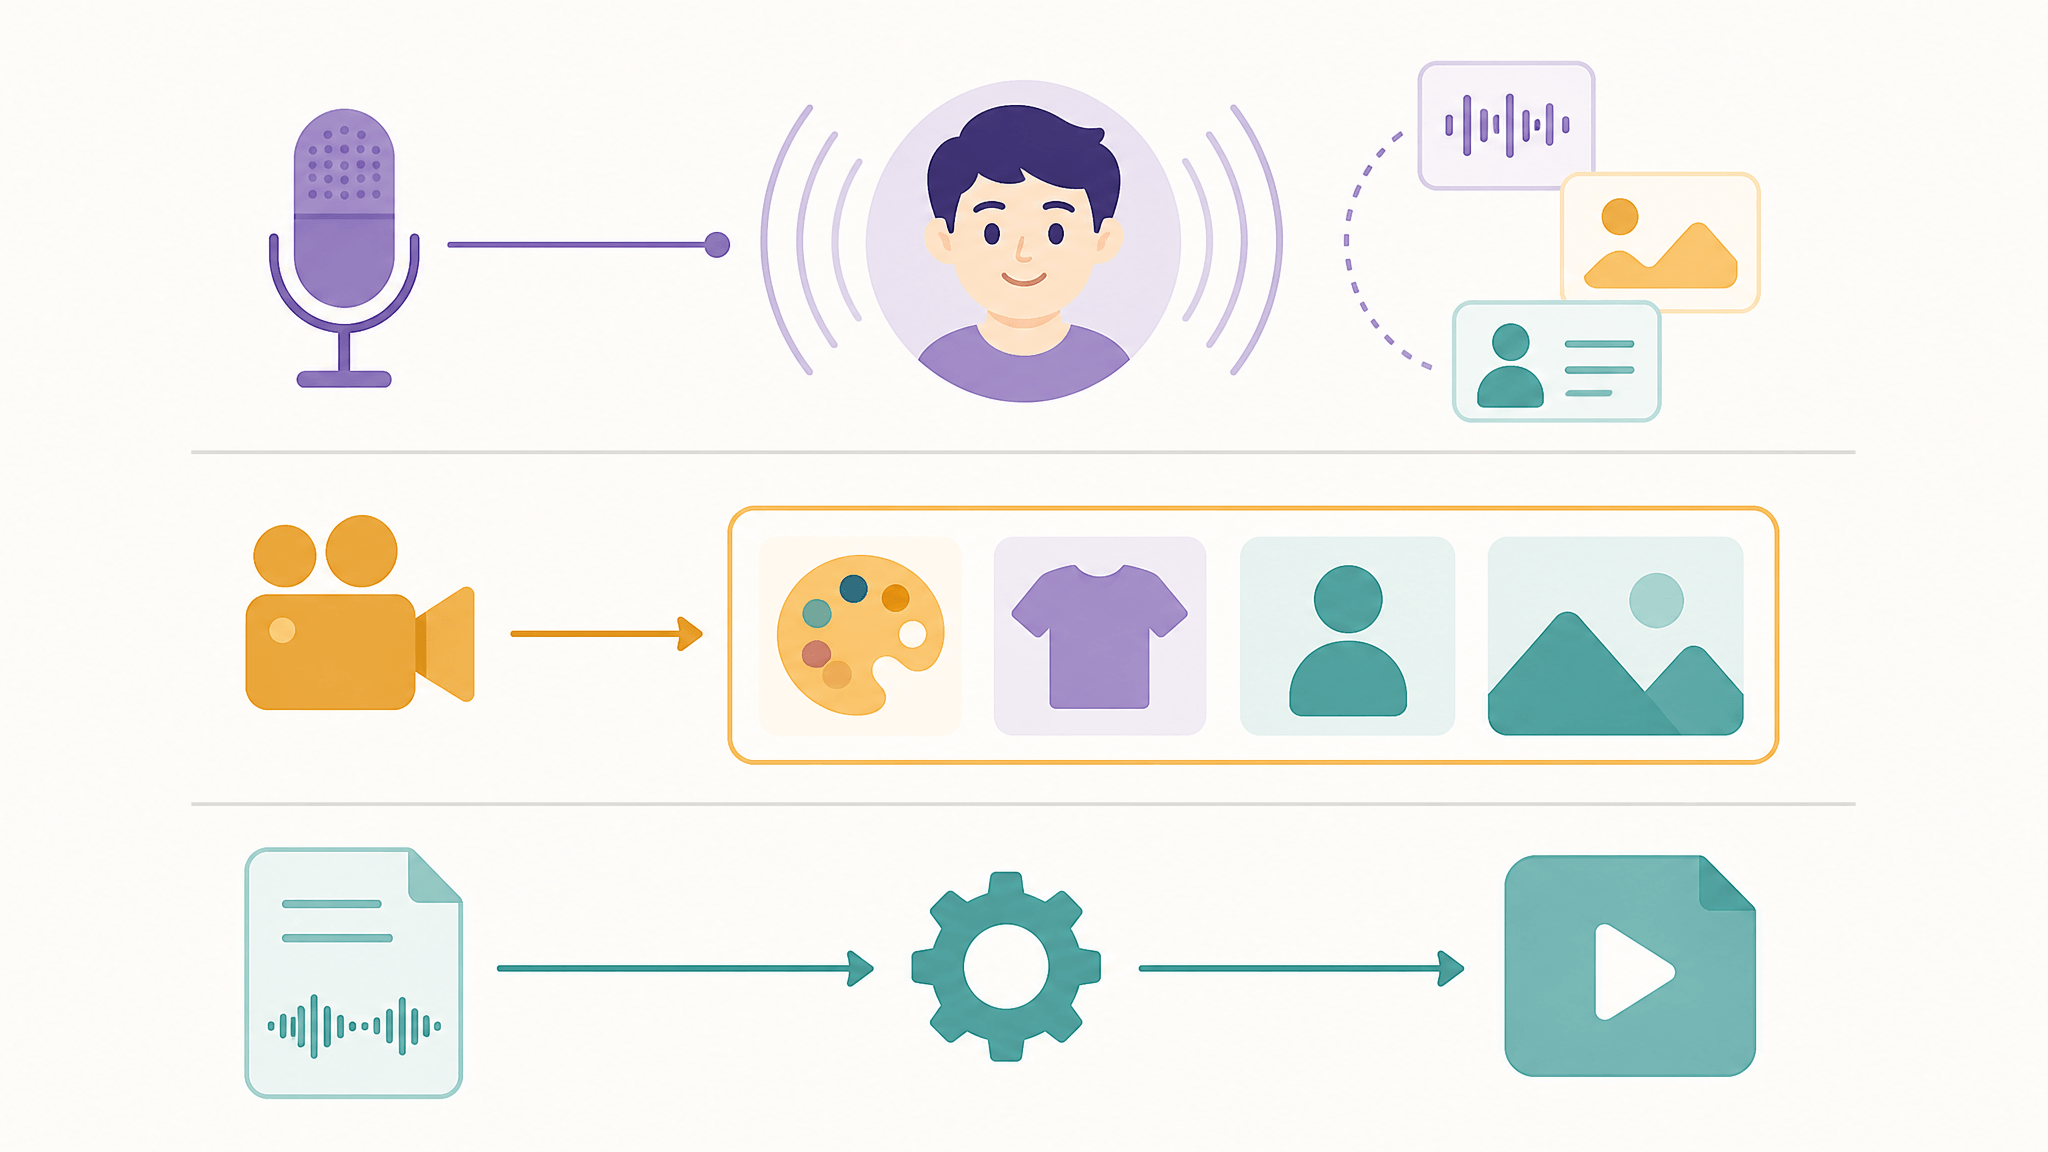
S2-Avatar 最直观的变化是分辨率:技术报告称实时生成达到 720p(S1 为 540p),同时保持 25–42 FPS。实现方式是一个轻量 Refiner 增加单步提升分辨率,让主干网络继续高速运行。这些数字请按官方自报对待——目前还没有独立延迟测试——但 720p 意味着输出开始达到手机屏幕上"可用"的观感,而不是一眼假。
对创作者更有意义的变化是动态参考图。在实时会话的任意时刻,你都可以给角色喂一张新图——物品、服装、背景——它会当场响应:拿起参考图里的杯子、穿上你刚丢进来的外套、切换到新场景。技术报告还描述了跨指令的状态保持:"拿起杯子,然后微笑"意味着角色举着杯子微笑;"摘下帽子再戴回去"会产生一个连贯的动作序列,而不是状态重置。指令遵循现在覆盖大幅肢体动作,比如听语音指令跳舞。
官方页面还画了一条值得注意的界线:实时模式是"在线"数字人——可打断、双向交互。此外还有离线模式:一张角色图加一段音频或文本脚本,通过普通异步生成变成口型对齐的视频。对大多数做 TikTok 和 Reels 的创作者来说,异步路径才是刚需,也是与现有数字人工具最直接的对照。
S2-Editing:边播放、边编辑
S2-Editing 的输入是已经在产生的画面——你的摄像头、上传的片段、甚至一张静态图——然后实时执行四种操作:风格渲染(整条流按参考图重新调色)、虚拟换衣、角色替换(换掉画面中的人)、背景替换。因为它编辑的是流而不是成品文件,编辑结果会跟随动作和镜头变化:主体抬手或转身,替换内容会跟踪。
工作流层面的影响比功能列表更大。参考图可以在视频流中途更换,场景切换也不会中断输出——你可以在一次录制里测试三种穿搭方向,而不是拍三条。对需要把一条素材分发到不同平台、不同热点的创作者来说,"拍一次,改 N 次"才是真正的产品。价格与画质表现这里不做结论——两者都还没有独立验证。
它解锁的三种工作流
依据官方产品页和技术报告,这些已公开的能力可以对应到三种短视频工作流。
1. 实时数字人主播。 从一张角色图开始,通过 S2-Avatar 的语音交互和观众对话,会话进行中随时推参考图——展示商品、换上周边、切换背景。这就是 VTuber/直播主播的形态,也是"实时"的真正用途:角色在你掌控的同时持续响应。
2. 拍一次,到处用。 拍一段普通素材,交给 S2-Editing 按目的地重新包装——一个平台要电影感调色,另一个要应季穿搭,热点在你拍完之后爆发就换背景。中途换参考图的能力让迭代变得快。
3. 异步数字人口播视频。 如果你不需要实时交互,离线数字人路径——一张图、一段脚本、一条成片——就是主流需求:为 TikTok、Reels、Shorts 批量产出角色类视频,不需要会时间线剪辑。对以发布为导向的创作者,这是产量最大的场景,也是现有异步工具已经覆盖的场景。
想上手的话:Vidu S2 官方演示 已在浏览器开放,也可以通过生数的平台接入 API 走流水线。
Vidu S2 官方产品页,2026 年 9 月 17 日访问。来源:vidu.cn/vidu-stream(生数科技)。
基准测试能说明什么、不能说明什么
这份技术报告在测试设计上给出的细节比数字本身更有价值。S2-Avatar 在 StreamAV-Bench 上评测——每个赛道 160 个场景,Interactive 赛道每 30 秒注入一次运行时更新、共五次、会话最长 180 秒。这个设计针对的正是实时演示最容易翻车的地方:打断、恢复、状态处理,而不是一次干净的生成。报告称 S2-Avatar 在九项指标上均领先所列对比模型,S2-Editing 在四个编辑基准(OpenVE-Bench、Sparkle-Bench、RefVIE-Bench、ViViD)上总分超过所列离线与流式基线。
这些基准不能告诉你的是:它跑你自己的素材效果如何、语音质量在你的语言里是否过关、以及这一切要花多少钱。这些数字来自模型自己的团队,成文时不存在独立评测,"超过基线"在官方报告里只是一个值得亲手验证的说法——好在开放演示让验证变得容易。
必须说清楚的限制
- 官方自报数字。 720p、25–42 FPS 和基准领先全部来自生数科技自己的报告与新闻稿。
- 我们没有实际运行它。 本文基于文档研究;工作流部分是方向性参考,不是实测结果。
- 消费端价格未经验证。 在我们能获取的来源中,演示的积分费用、订阅条款和产出配额均未公布;公众号原文对我们存在验证门槛,因此本文以英文新闻稿和官网为准。
- 空间视频是演示,不是功能。 把实时流转成左右眼画面在 VR 头显观看属于探索方向,没有消费级上线时间表。彭博社报道字节跳动基于 Seedance 做类似方向(张一鸣督导)是行业背景,不构成对任何一方产品的确认。
- 商用条款因模型而异。 产出内容的商业权利取决于服务商条款和所在司法辖区——对任何 AI 视频模型都成立,包括你现有工具链里的那些。
它在你的创作流水线里处于什么位置
S2 展示的能力和多数创作者每天实际发布的内容之间,有一条有用的分界线。实时交互面向"在线"场景——直播、可交互角色、有观众在场的会话。而可发布的短视频内容大多仍是异步的:写好、生成、审核、发布。S2-Avatar 的离线数字人模式本身就承认了这一点,也正是与现有工具直接竞争的模式。
如果你这周的实际任务是一批数字人口播视频——而不是一场实时直播——异步生成工具今天就能做。这就是 AI Fruit 水果说话视频工具:一条提示词一条成片,为 TikTok、Reels 和 YouTube Shorts 生成嘴型生动、个性夸张的水果角色视频,花多少积分、用什么模型,生成之前看得清清楚楚。
结论
Vidu S2 把实时数字人交互和实时视频流编辑作为一个完整开放的系统交付——当天全员可用,而不是锁在研究预览里——开放演示意味着你今天就能亲手压力测试,而不是只信基准表。做直播,S2-Avatar 值得一试;复用素材,S2-Editing 的"拍一次改 N 次"是实用卖点;只需要可发布的角色类视频,异步路径——无论哪个工具,包括我们——仍然是主力。
用 AI Fruit 生成你的视频,把 Vidu S2 留在直播场景的关注清单上。