
Tiny Desk AI 视频是怎么火的,以及怎么用你自己的照片做一个
Tiny Desk AI 趋势从哪来?为什么所有版本都剪同一段 NPR 演出的 19 秒?一篇讲清来源、换脸流程和版权现实,另附更简单的原创生成路线。
Tiny Desk AI 视频是怎么火的,以及怎么用你自己的照片做一个
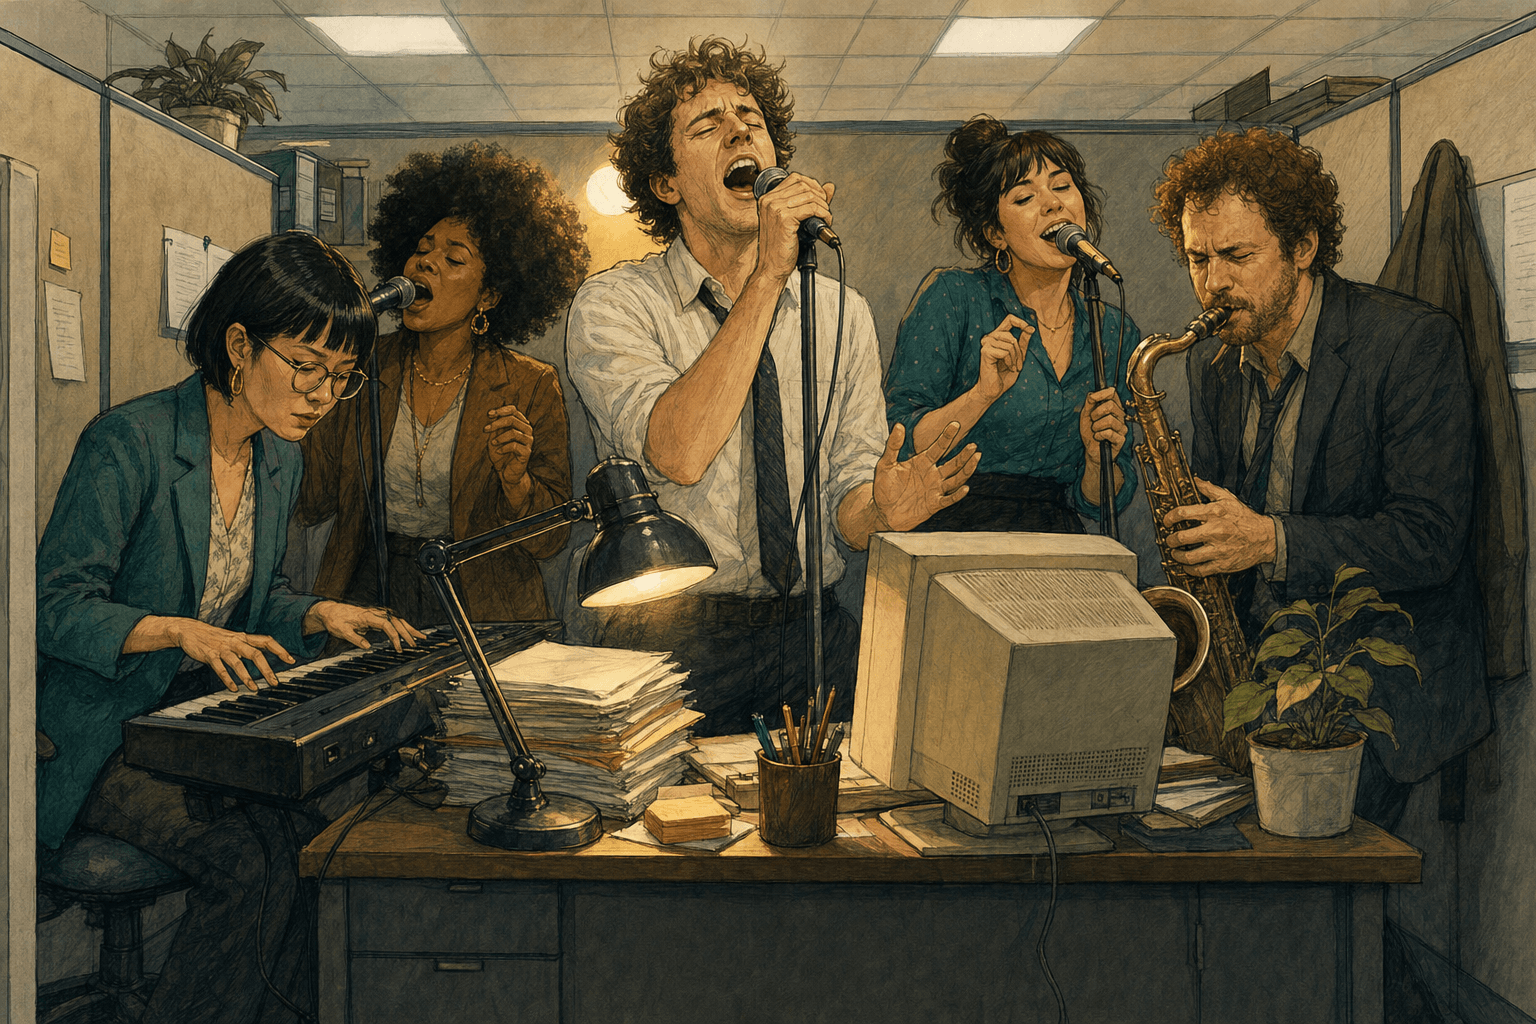
你大概已经刷到过:一支乐队挤在小办公室的一张办公桌后面演出,可每个乐手的脸都换成了另一个人的——大学橄榄球教练、朋友、甚至你的老板。这类「Tiny Desk AI」视频在 2026 年 10 月下旬火遍全网,几天内就攒下数百万播放,而它们 remix 的都是同一段 NPR 演出的 19 秒。这篇文章讲清楚这个趋势从哪来、为什么所有版本都剪同一段素材、把自己的脸放进去到底需要什么,以及如果你只想用自己的照片生成一支 AI 演出视频,还有更简单的路。
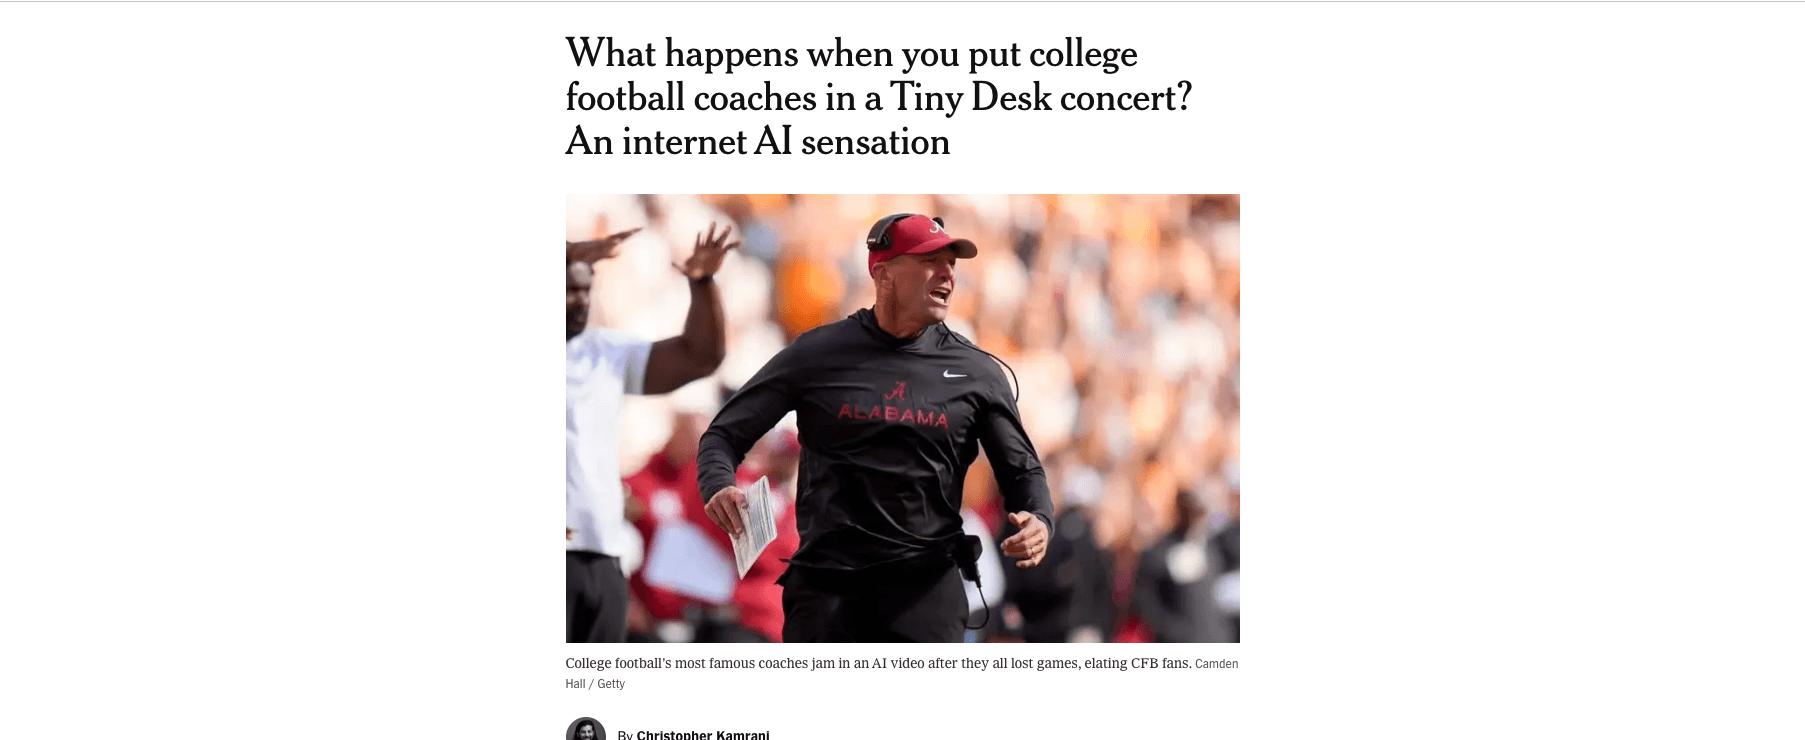
来源:The New York Times / The Athletic,〈What happens when you put college football coaches in a Tiny Desk concert?〉,2026 年 10 月 23 日。
Tiny Desk AI 趋势到底是什么
Tiny Desk Concerts 是 NPR(美国公共广播电台)从 2008 年开始录制的现场音乐系列,地点就在华盛顿总部的一张办公桌后面,至今已有约 1800 场。AI 趋势借用的正是其中一场:2023 年 6 月,R&B 传奇歌手 Charlie Wilson 在 Tiny Desk 演出的结尾唱了 The Gap Band 1982 年的名曲《Outstanding》——这首歌本来就常年被网友用来调侃「过气」的运动员和明星。
点燃趋势的视频发布于 2026 年 10 月 18 日。一个跑 burner 账号 @theburnerfromhe11 的 23 岁阿拉巴马球迷,在经历了疯狂的周六之后出手:全美常规赛历史上第一次,AP 排名前七的球队里有五支(得州、印第安纳、佐治亚、阿拉巴马、圣母大学)在同一天输球。他把这些输球教练全部塞进了乐队——阿拉巴马的 Kalen DeBoer 领唱,得州的 Steve Sarkisian 和印第安纳的 Curt Cignetti 伴唱,佐治亚的 Kirby Smart 打铃鼓,圣母大学的 Marcus Freeman 吹萨克斯。创作者接受 The Athletic 采访时说,视频是用 Higgsfield AI 平台加动作迁移(motion-transfer)模型做的。
几天之内,这支视频在 TikTok 上超过 200 万播放,Instagram 上 200 万,X 上最高 600 万曝光(均为创作者自述数据)。Snoop Dogg 转发了它,连 Tiny Desk 节目制作人 Alanté Serene 都跑到评论区开玩笑说「我要打电话给我们的法务了」。一个格式只要能稳定收获这种反应,模仿就停不下来——随后出现了达拉斯牛仔名宿版本,TikTok 现在把整个格式叫作「outstanding tiny desk」。
为什么所有版本都剪同一段 19 秒
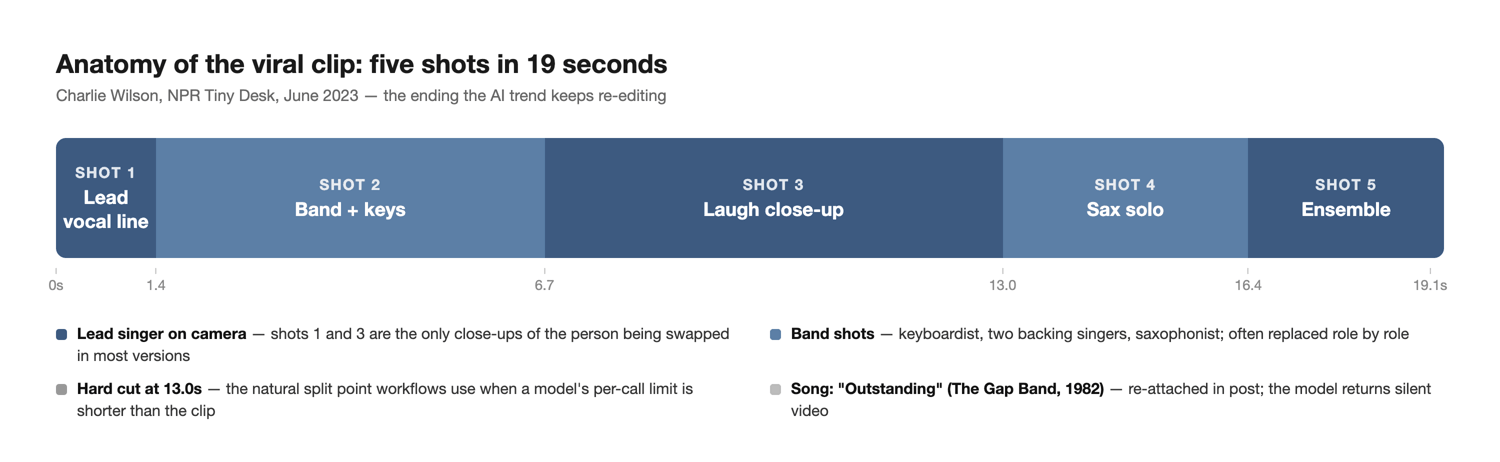
梗视频用的素材是 Charlie Wilson 演出的最后一段——大约 19 秒,从 NPR 视频的 23:46 附近开始——它有固定的五镜头结构:领唱开口(0–1.4 秒)、键盘后的乐队(1.4–6.7 秒)、领唱大笑特写(6.7–13 秒)、萨克斯独奏(13–16.4 秒)、全员合奏收尾(16.4–19.1 秒)。
这个结构正是没人从零 prompt 生成的原因。整段视频的看点就是「认出原片」——那个房间、那些切换、那个节奏——然后脸换了。如果你凭空生成一个相似场景,让人停下滑动的那个东西就没了。而且原曲必须和画面里的演唱动作对上,所以实践者的做法是:把爆款原片当参考视频(reference video)喂给支持视频编辑的 AI 模型,让它逐镜头替换里面的人。
怎么做一个属于你自己的 Tiny Desk AI 视频
先说清楚:这套流程是文档化的整理,来自 The Athletic 对原作者的采访,以及 2026 年 10 月下旬公开的两篇详细测试/工具文档,不是我们亲手跑出来的实测。每个人的产出都不会完全一样,下面的细节应当被当作「被报告过的实践」,而不是保证。
你需要准备:
- 那段约 19 秒的竖版参考视频;
- 每个要换入的人一张清晰正脸照片(要有本人授权);
- 一个支持参考驱动编辑的视频模型——能同时接受参考视频和图片参考,而不是纯文生视频;
- 一个做最终音频处理的视频编辑器。
流程如下:
- 准备人像。 用光线好、脸清楚的照片;暗光裁切、墨镜、多人合照都会明显降低换脸质量。确认你有权使用并呈现这个人的形象。
- 设置参考。 模型需要原片作为运动和构图的参考,再加上你的人像作为所要替换角色的身份参考。
- prompt 写「保持」,不写「表演」。 文档里验证过的 prompt 模式很短:指出要替换的人,按照片描述他的样子,然后告诉模型其余一切保持不变——动作、表情、镜头、背景。
- 一个角色一张脸。 在公开的测试记录里,把同一组照片同时派给两个角色(比如领唱兼键盘手)时模型谁也没换;一个角色一张脸才能换干净。
- 检查输出里的脸。 换失败的生成照样返回「成功」状态。分享之前务必确认原片里的人真的被换掉了。
- 把歌放回去。 模型返回的是无声视频;《Outstanding》音轨是后期贴回去的。同时导出一份无声版,因为平台可能会把这段商业录音静音。
真正要命的几个坑:
- 永远别在 prompt 里提嘴。 某团队的 32 次公开测试渲染记录显示,只要 prompt 里出现 lip-sync 之类的嘴部描述,嘴就会全程动个不停——包括歌手只是咧嘴笑的部分。完全不提嘴,反而最贴合参考。
- 奇数长度的参考片段会被弄坏。 编辑模式要求参考片段是整秒数且至少 4 秒;长度不对的参考会被截断或补尾,所以讲究的流程会把 19 秒原片从 13 秒的硬切点拆开,分别处理后再拼回去。
- 口型不会逐字对上。 即便把原曲作为音频参考喂进去,嘴也可能漏掉音节或在间奏继续动。预期「足够像」,别指望精确。
- 一次生成只换一次。 多留几次尝试预算;公开的流程里,单个镜头经常要重跑好几遍才干净。
版权和品牌的现实
发布之前有三件事值得知道。第一,Tiny Desk 是 NPR 的节目品牌,趋势爆发后几天内冒出来的第三方「Tiny Desk AI」工具都带着明确的免责声明——独立恶搞工具、与 NPR 或 Tiny Desk Concerts 无关联。NPR 自己的制作人看到教练版视频时的反应都是「要叫法务了」的玩笑——这条品牌线是真实存在的。第二,那段音频是一段有版权授权的现场录音,不是随便可用的热梗音效;这正是平台会静音部分版本的原因,也是有经验的创作者会导出无声版、回到 App 内再加音频的原因。第三,只用拍得本人同意的照片——把一个真人的脸可信地换进视频而未经同意,是让一个玩笑迅速变成麻烦的最快方式。
更简单的路:生成一支你自己的 AI 演出视频
上面的一切都是为了做出「那一段」视频。但如果你想要的其实是一支属于自己的 AI 演出视频——你站在麦克风前,你的朋友们当乐队——那你根本不需要 NPR 的素材。一个图生视频(image-to-video)生成器只要一张人像照加一段描述,就能产出原创的演出场景:舞台、灯光、乐器、运镜都由你定义。你放弃的是梗本身的原片辨识度,换来的是对创意的完全掌控,不用翻找参考视频,也不用做 ffmpeg 音频手术。
AI Fruit 就是这么工作的:选一个视频模型,上传你的照片,描述想要的演出场景,生成前就能看到设置和积分费用——像 Seedance 2.0 这样的模型还支持参考图片,用来引导每个人在不同镜头里的样子。
不想自己折腾整套流程?直接在 AI Fruit 用一张照片生成你的 AI 视频——你的原创作品,不需要碰时间线。
AI Fruit 是独立工具,与 NPR 或 Tiny Desk Concerts 无关联。本文仅出于编辑目的介绍该趋势;Tiny Desk 是 NPR 的节目名称。
FAQ
Tiny Desk 视频用的是哪个 AI 模型? 公开的流程使用支持参考驱动编辑的模型——原作者提到的是 Higgsfield AI 加动作迁移,公开测试文档用的是字节跳动 Seedance 系列的视频编辑模式。原则上,任何能同时接受参考视频和图片参考的模型都能做替换;效果因模型和设置而异。
AI 视频能把歌词口型对准吗? 不能。即便把原曲作为音频参考,嘴也可能漏音节或在间奏继续动。文档里的经验是完全不提嘴部,接受「足够像」。
发出去音频一定会被静音吗? 不一定。这首歌是 NPR 的授权录音,平台可能会静音。常见的做法是导出无声版,回到 TikTok 或 Instagram 内部添加热门音频。