
提示词直出视频:LaunchVideo 这类 AI 视频生成器怎么选?
LaunchVideo 输入网址或提示词,约四分钟产出一支 20–40 秒的发布视频——全程没有视频模型。代码渲染与生成式视频两条路线怎么选、怎么组合,一篇讲清。
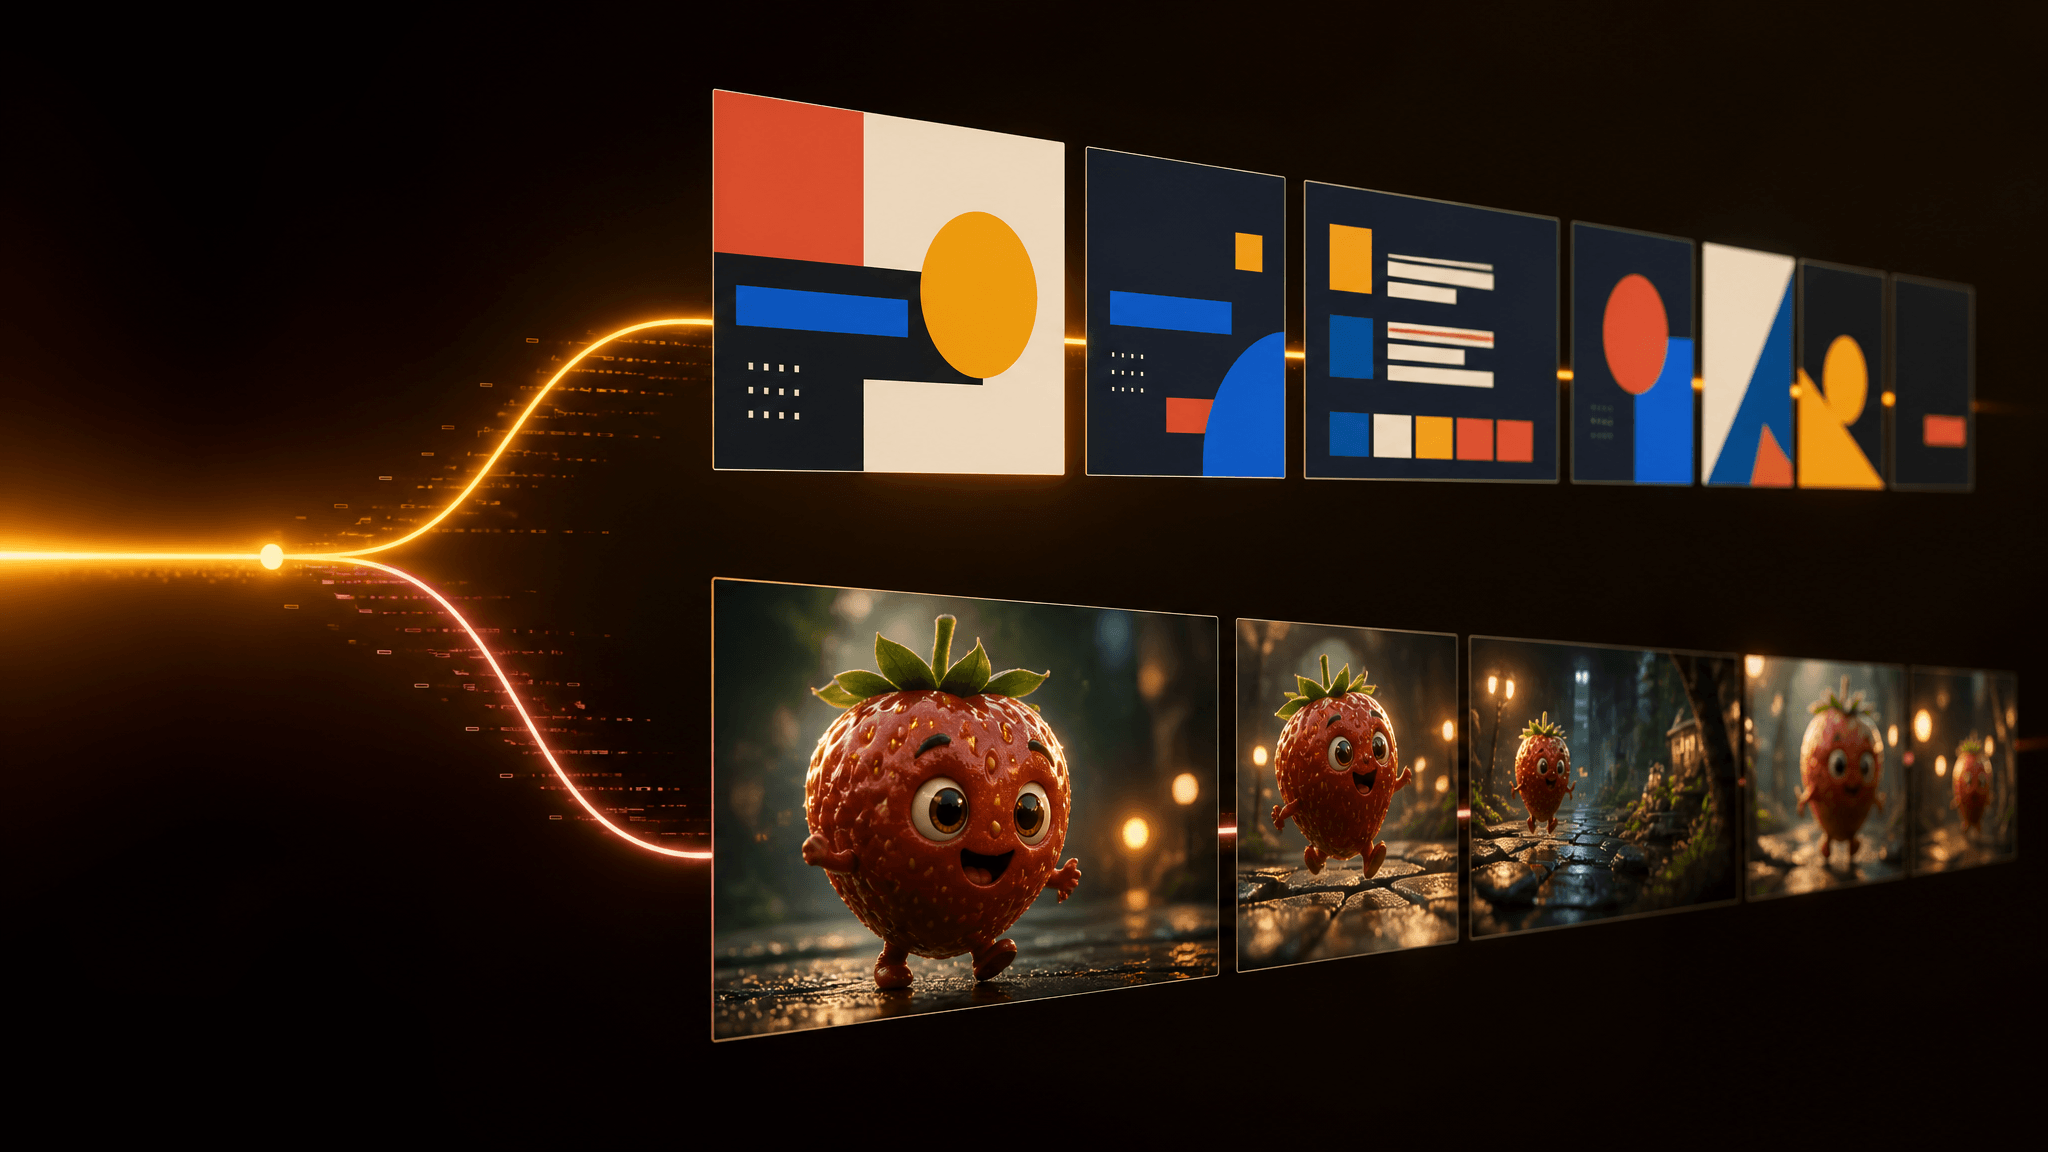
把一个产品网址粘进 LaunchVideo,大约四分钟后,你就能拿到一支成片——没有实拍、没开剪辑软件,而且可能出乎你意料:全程没有用任何视频模型。这支 2026 年 9 月 24 日发布的工具体现了短视频创作者必须搞懂的一个分野:「提示词直出视频」的工具,背后其实是两套完全不同的引擎,产出的结果也截然不同。
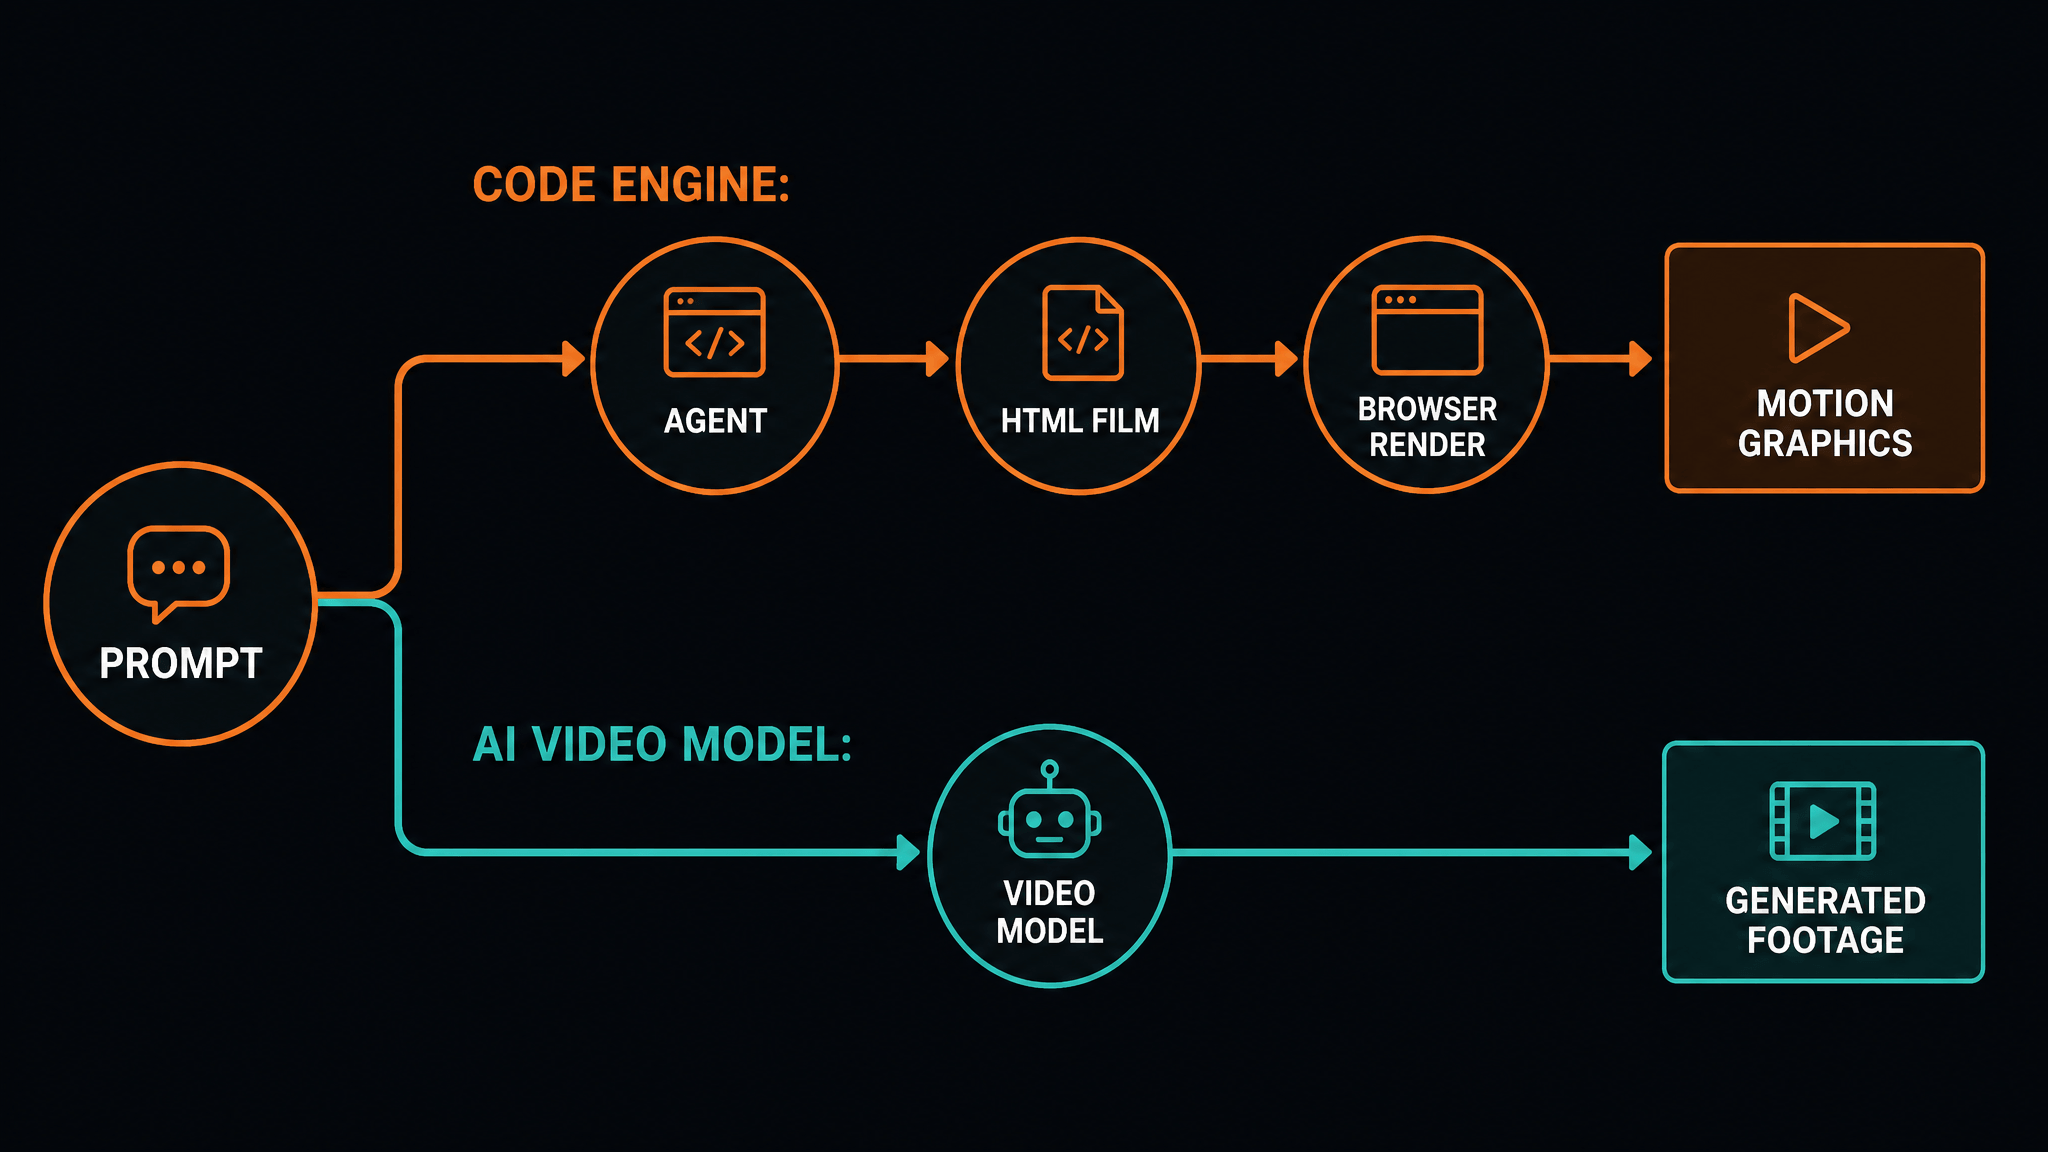
第一套引擎「生成素材」:输入文字和图片,AI 视频模型凭空生成画面——过去两年里,大家搜「AI 视频生成器」时看到的基本都是这一类。第二套引擎「写代码」:一个编码智能体把你的视频写成一段程序,再由浏览器渲染执行——产出的是带精确文案和品牌色的动态图形,确定性强,但拍不出任何实景画面。
你该用哪一套?答案取决于任务本身,而不是哪个工具声量更大。要求文案分毫不差的产品宣传片适合代码路线;需要视觉世界、产品实拍或创意场景的内容离不开生成路线。真实的工作流里,两者经常出现在同一支视频中。这篇指南会用 LaunchVideo 作为这条较新引擎的具体样本,讲清两套引擎各自的原理、各自的边界,以及如何组合使用。
LaunchVideo 到底做了什么
LaunchVideo 的入口只有一个输入框:粘贴产品网址,或者用一段话描述产品,然后拿回一支 20 到 40 秒的发布视频。每次运行都是一遍过——一次输入,一个 MP4,成片后不再进时间线剪辑。据项目 README 和官网的说明,一次运行大约耗时四分钟、消耗约 10 万 token,最终产出一个可直接分享的 MP4 链接。
官网的示例区展示了多支单次运行的作品:NVIDIA、Linear 等站点的成片都在 31 到 34 秒左右,还有一支纯靠提示词「为一家做推理服务的现代初创公司,做一支现代、利落、有冲击力的视频」生成的作品。LaunchVideo 同时开源,截至撰稿时仓库才提交几次,如果你愿意自己跑,可以一键把整个智能体部署到自己的账号里。
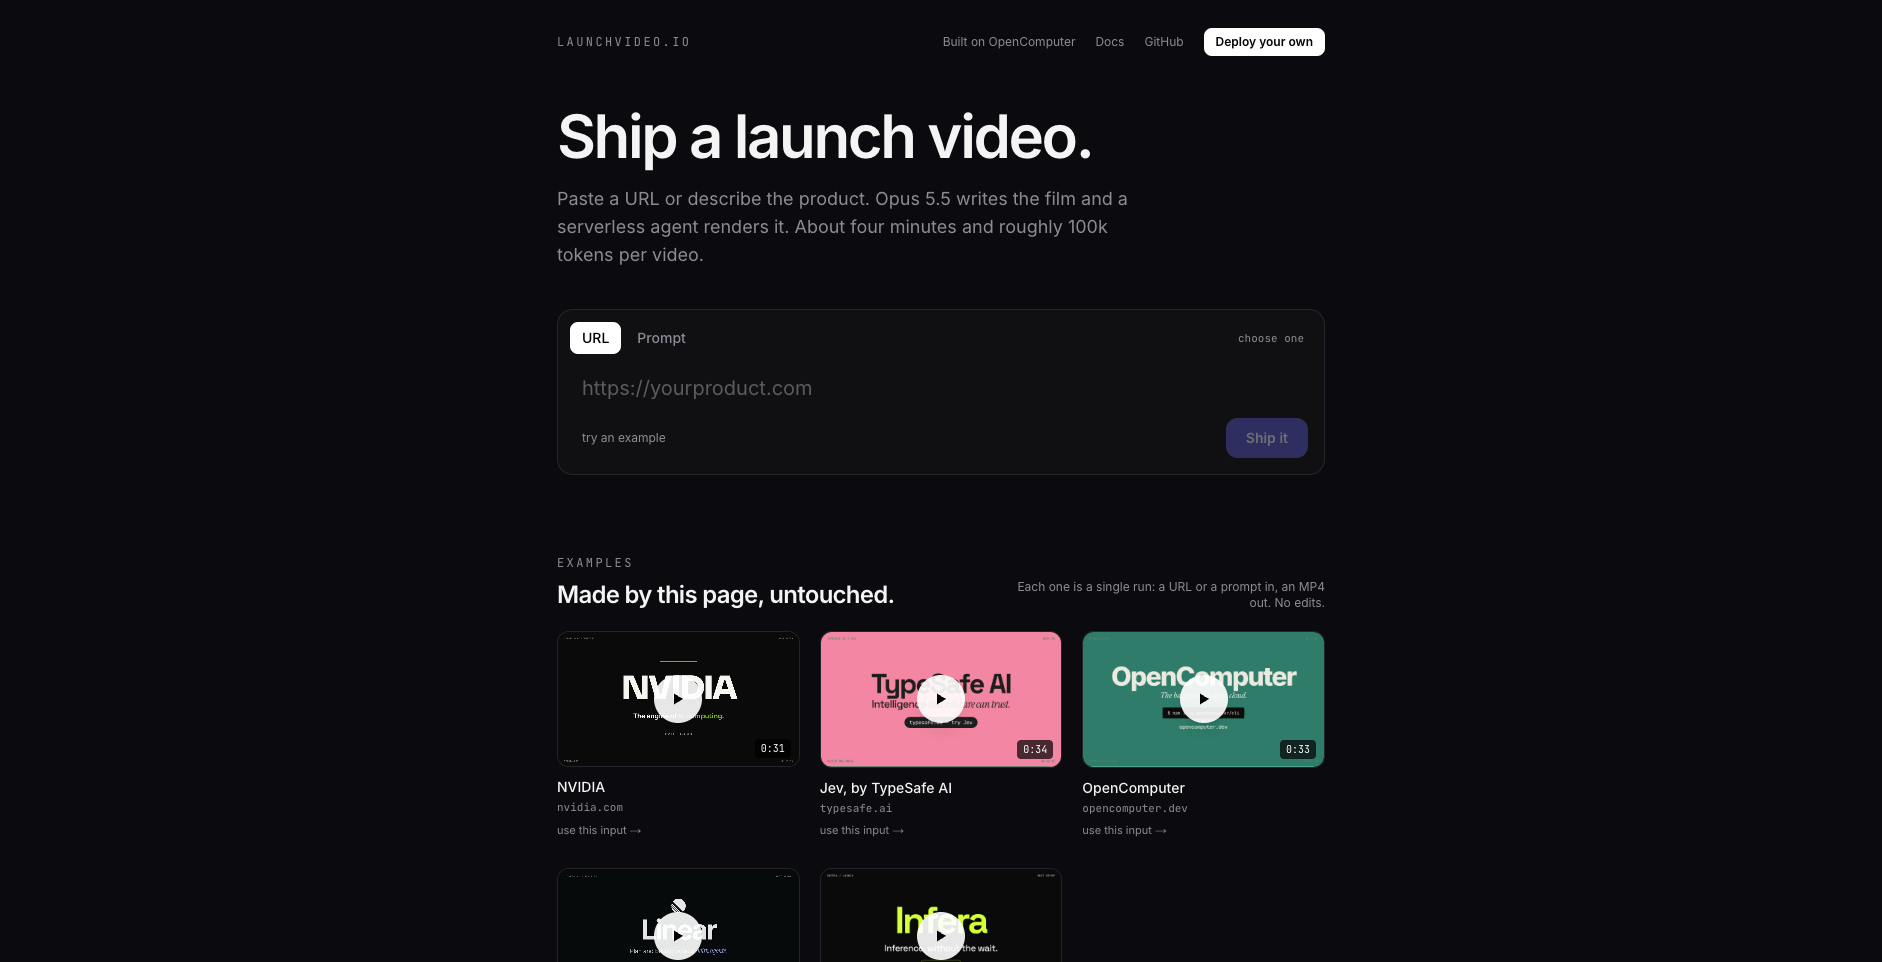
来源:launchvideo.io,2026 年 9 月 25 日访问。
引擎盖下看一眼:视频是代码,不是素材
让人意外的地方在这里:LaunchVideo 完全没有使用视频模型。一个 Claude Opus 编码智能体把你的视频写成一个自包含的 HTML 文档——动态文字排版、转场、品牌色图形、定时出现的文案——然后由一个无服务器智能体在无头 Chromium 浏览器里逐帧渲染这份文档,再把帧序列交给 ffmpeg,以 1920×1080、30fps 编码成片。
在 URL 模式下,智能体先抓取你的网页,提取标题、各级标题、使用最多的十六进制色值和 Google 字体——所以成片会自动「穿上」你网站的品牌外衣。README 对场景规则写得很明确:不能内嵌视频、音频或 iframe,不能引用外部图片,不允许随机性。渲染时的每一只时钟都是虚拟时钟,这让输出完全确定——同样的输入,永远渲染出同样的视频。这也正是项目标语(致敬启发它的那个演示)的由来:模型把影片写成代码,而代码每次渲染的结果都一样。
你可以把它理解成一位「打字速度」的动态设计师。产出确实有手工动效的精致度——因为它本来就是手工动效,只是把几天的工作量压缩到了几分钟。
代码渲染视频的能与不能
那些场景规则就是能力边界,创作者不妨把它们读成一张能力地图:
适合的场景:
- 产品发布宣传片、更新公告——文案必须一字不差的场合,渲染不会像生成模型那样把屏幕文字「画坏」
- 品牌感精准的开场动画:URL 模式自动复用你网站真实的配色和字体
- 快速产出的广告式钩子、社媒公告视频——20 到 40 秒本来就够用
做不到的事:
- 一切实拍内容:人物、手部动作、真实环境里的产品。渲染器只会画图形和文字,无法展示你的产品被真实使用的样子
- 凭空创造的视觉世界、角色或场景——没有外部图片,也没有生成帧
- 带声音的动态画面;流水线产出的是无声 MP4,配乐要在剪辑软件里完成
如果你的视频任务是「把一句话说清楚,且品牌细节要精准」,代码引擎现在已经是一个值得认真对待的一键选项。如果你的视频任务是「展示点什么」,那它需要另一套引擎。
另一套引擎:生成式 AI 视频生成器
今天创作者搜「AI 视频生成器」,排在前面的几乎全是第二套引擎:建立在 Veo、Kling、Sora、Seedance 这类视频模型之上的平台——文字或图片提示词进去,凭空生成的画面出来。这些模型恰恰在代码渲染到不了的地方发光:超现实场景、产品风格 B-roll、风格化世界、角色,还有让 AI 水果视频在 TikTok 上爆火的那类抓眼球内容。
代价同样来自结构本身。生成结果是采样的,同一个提示词跑两次,画面不一样;屏幕文字可能崩坏;画质、速度、分辨率和音频表现取决于你选哪个模型;积分或定价通常随模型和设置浮动。你用代码引擎的确定性,换来「展示从未被拍摄之物」的能力。
快速决策表:
| 你的任务 | 更合适的引擎 | 原因 |
|---|---|---|
| 带精确标语和品牌色的发布宣传片 | 代码渲染 | 文字确定,URL 模式自动带品牌 |
| 产品 B-roll、情景演绎、风格化场景 | 生成式模型 | 能生成从未实拍的画面 |
| 赶时间的更新公告视频 | 代码渲染 | 文案准确性比视觉新鲜感重要 |
| 热点内容、水果风视觉、角色演绎 | 生成式模型 | 采样本身就是卖点 |
| 无声广告钩子 + 精确文案 | 代码渲染 | 输出本来就是无声的 |
| 一支视频既要信息又要画面 | 两者都用 | 动态图形做外壳 + 生成画面做主体 |
两条引擎组合使用的实战流程
两套引擎与其说是对手,不如说是同一套工作流的两个层次。下面是一个规划用流程——基于公开文档整理的思路,而非实测脚本,时间数字请当作估算:
-
用代码渲染做开场钩子。 把产品网址(或一段收紧的提示词)喂给 LaunchVideo 这类工具,拿到一支品牌精准、文案无误的 20–40 秒开场片段。
-
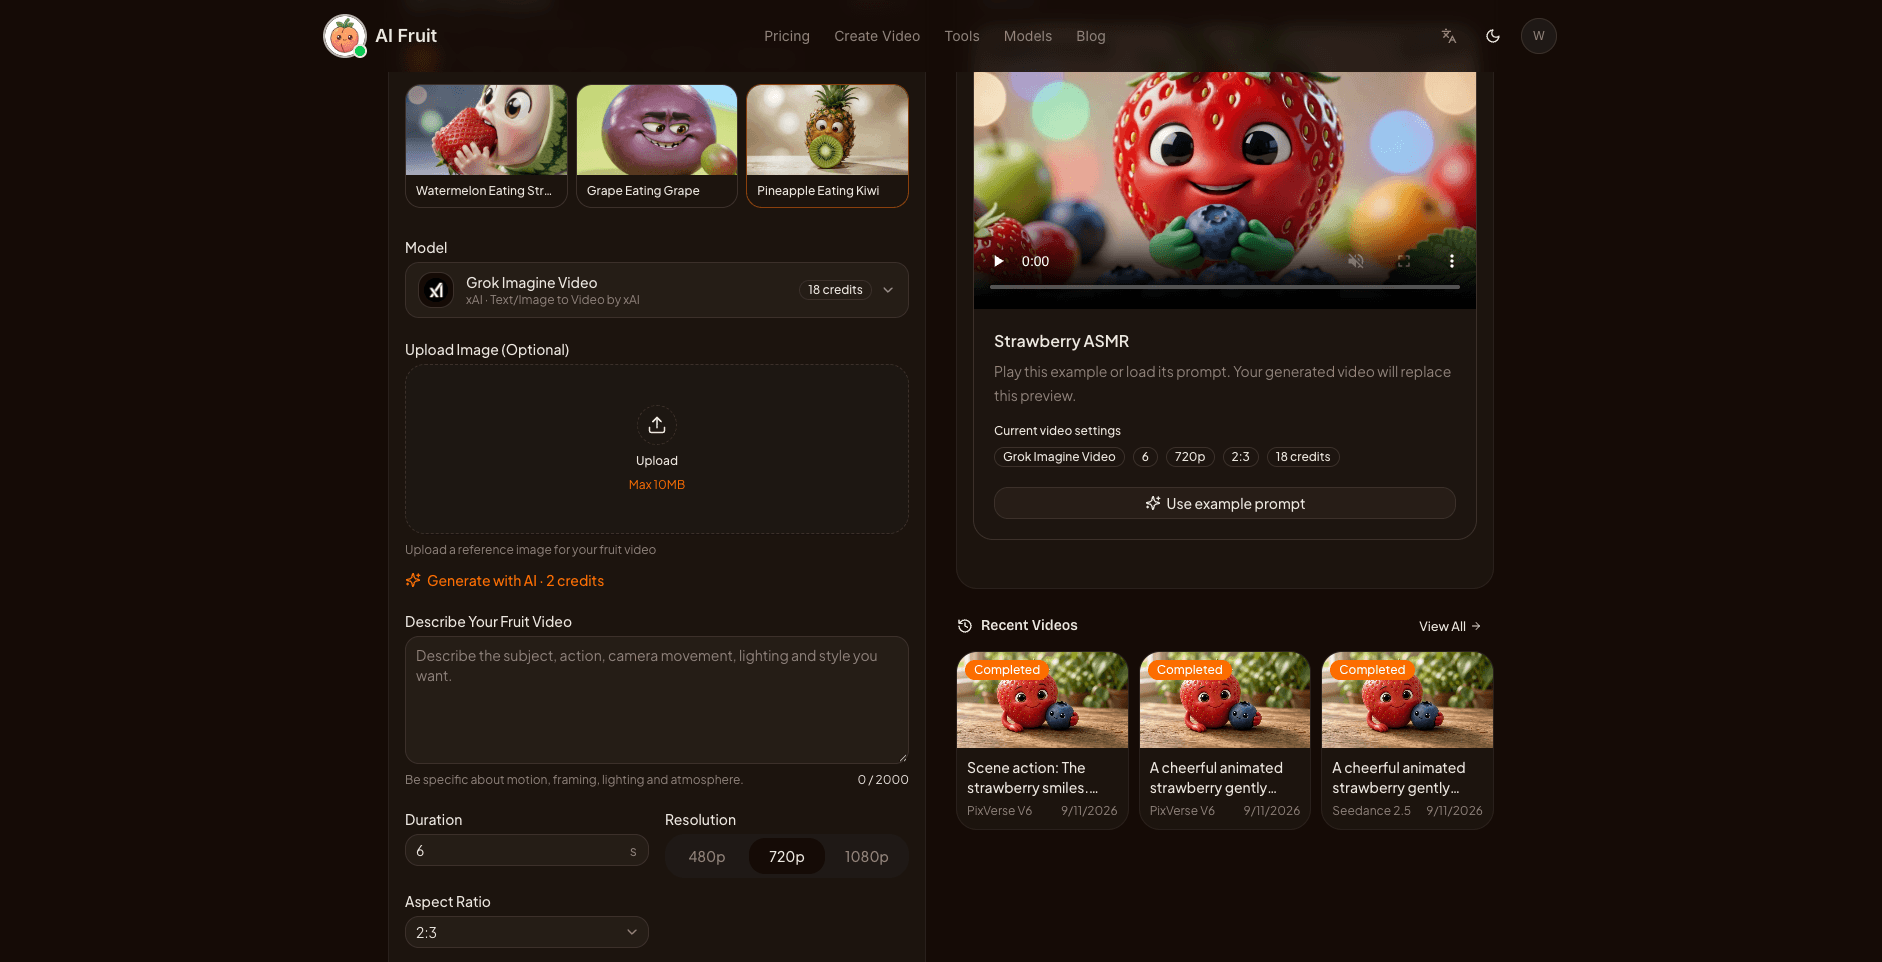
生成主体画面。 为镜头「该看到什么」逐场写提示词——语境中的产品、风格化 B-roll、超现实抓眼球画面。这一步,一个把模型信息摆到明面上的平台能帮你省下真金白银:你可以对比多个模型、在生成前看到预计积分消耗(在展示的情况下),逐场选择,而不是靠猜。AI Fruit 的 AI 视频生成器正是这样设计的——支持提示词、图片、模板、工具、模型五种创作入口,生成前就能看到模型选项和预计积分消耗(在展示的情况下),还有支持多场景断点续作的 Story 模式。
-
回到常用剪辑软件组装。 把动态图形开场叠在生成画面上,按平台习惯加音乐和字幕,导出发布。
-
一支视频只许一个主角。 如果信息是主角,就用代码渲染图形领衔、生成画面点到为止;如果画面是主角,就先做生成,再用一小段品牌片尾收束信息。
这套组合的意义在于让每套引擎只做它被证明擅长的事:外壳负责精确的文案与品牌,主体负责被创造出来的画面。
本周就能上手的入口
两套引擎的试错成本都很低。LaunchVideo 在官网一个输入框就能跑;想自己持有整条流水线,可以从开源仓库一键部署。生成式这一侧,选平台时优先挑那些在生成前就把模型信息和积分成本摆出来的——用同一个场景在两三个模型上各跑一次,你对差异的理解会超过任何参数表。
一句话收尾
「提示词直出视频」不再是一项技术。LaunchVideo 这类代码渲染工具把网址或提示词变成确定的、品牌精准的动态图形——适合信息必须分毫不差的场合;生成式 AI 视频生成器把提示词变成凭空创造的画面——适合展示尚不存在的东西。先分清工具背后的引擎,再按任务选择;当一支视频既要精确信息又要生成画面时,就把两套引擎装进同一条工作流。