
MiniMax H3 VBVR LoRA:安装与使用教程(附官方对比说明)
VBVR LoRA(H3-Licon-VBVR-I2V)针对 MiniMax H3 图生视频中的物体复制与动作逻辑问题。本文讲清 ComfyUI 安装步骤、官方对比实际展示了什么,以及在投入约 40 GB 模型文件前需要知道的事。
MiniMax H3 VBVR LoRA:安装与使用教程(附官方对比说明)
VBVR LoRA 是 MiniMax H3 图生视频工作流的一个 149 MB 附加组件,针对三类具体失败模式:物体在运动中莫名复制、角色穿模、动作序列逻辑断裂。安装只需两步——把 H3-Licon-VBVR-I2V.safetensors 放进 ComfyUI/models/loras/,然后在 H3 图生视频工作流的 LoRA 加载器里选中它。真正麻烦的是它周围的一切:VBVR 挂在 33B 参数的底模上,你得先让 H3 本身在 ComfyUI 里跑起来,准备约 40 GB 的模型文件和能带动它的 GPU。
这篇教程覆盖整条链路:VBVR 到底是什么(这个名字来自一套视觉推理训练集,不是营销词)、如何装好 H3 基础工作流、如何接入 LoRA、官方发布的对比视频实际展示了什么——以及在本地跑 33B 视频模型超出你预期时该怎么办。
快速事实
| 文件 | H3-Licon-VBVR-I2V.safetensors(149 MB) |
| 发布方 | LiconStudio,2026 年 10 月 23 日发布 |
| 作用于 | MiniMax H3 图生视频(FL2VA)工作流 |
| 许可证 | Apache 2.0(LoRA 本体);MiniMax H3 Community License(底模) |
| 热度 | Hugging Face 上近一个月约 10,000 次下载、165 个赞(2026 年 11 月 4 日查询) |
| 用法 | 放入 ComfyUI/models/loras/,在工作流的 LoRA 加载器中选中 |
先说一个命名坑:README 里让你下载 H3-VBVR-I2V.safetensors,但仓库里的实际文件已改名为 H3-Licon-VBVR-I2V.safetensors。权重相同,只是改名——别去找一个不存在的文件。
VBVR 到底是什么
VBVR 指的是一项公开发表的研究:VBVR-Pro,一个"可扩展、可验证的原生视觉推理套件"。研究者程序化生成视频推理任务——把物体移出画面再移回来且不能变、把恰好三个苹果装进纸袋且不能多不能少、一步步解开屏幕上的谜题——并用基于规则的确定性打分替代裁判模型。它的视频微调子集 VBVR-Pro-SFT-Video 包含 124 万条生成样本,覆盖 250 个任务族,分辨率 512×512。
VBVR LoRA 就是围绕 H3 重建的这套训练数据。据模型卡说明,LiconStudio 针对 H3 的训练管线重新处理了 VBVR-Pro-SFT-Video 数据,把"结构化的运动与交互模式"蒸馏进 LoRA。三项声称的改进与任务风格一一对应:
- 减少物体复制——运动中不再凭空多出物体(计数与"消失再出现"任务正瞄准这一点)
- 减少穿模与互渗——角色、物体、表面之间的空间关系更干净
- 改进角色动作逻辑——整段视频里动作序列保持连贯
别把它和搜索排名很高的 Patarapoom/h3-vbvr 仓库弄混。那个仓库是约 41 GB H3 文件(扩散模型、文本编码器、VAE)的原样转存,为 RunPod serverless 缓存而建——里面捆了一个约 30 MB 的社区"attention-only" VBVR 变体,但它不是本文讲的 Licon LoRA,也没有做任何再训练。要下本文覆盖的 LoRA,请认准 LiconStudio 仓库。
装 LoRA 之前:先让 H3 在 ComfyUI 里跑起来
VBVR 插在现成的 H3 图生视频工作流上——它不能独立运行。官方路径是 ComfyUI 的 MiniMax H3 I2V 模板(Workflow Library → Video),要求 ComfyUI 0.30.0 或更新版本,以及 Comfy-Org 转存好的这些文件:
| 文件 | 放置目录 |
|---|---|
minimax_h3_fl2va_pruned_int8_convrot.safetensors |
models/diffusion_models/ |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
models/text_encoders/ |
minimax_h3_video_vae_int8_convrot.safetensors |
models/vae/ |
minimax_h3_audio_vae_fp32.safetensors |
models/vae/ |
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors(可选提速 LoRA) |
models/loras/ |
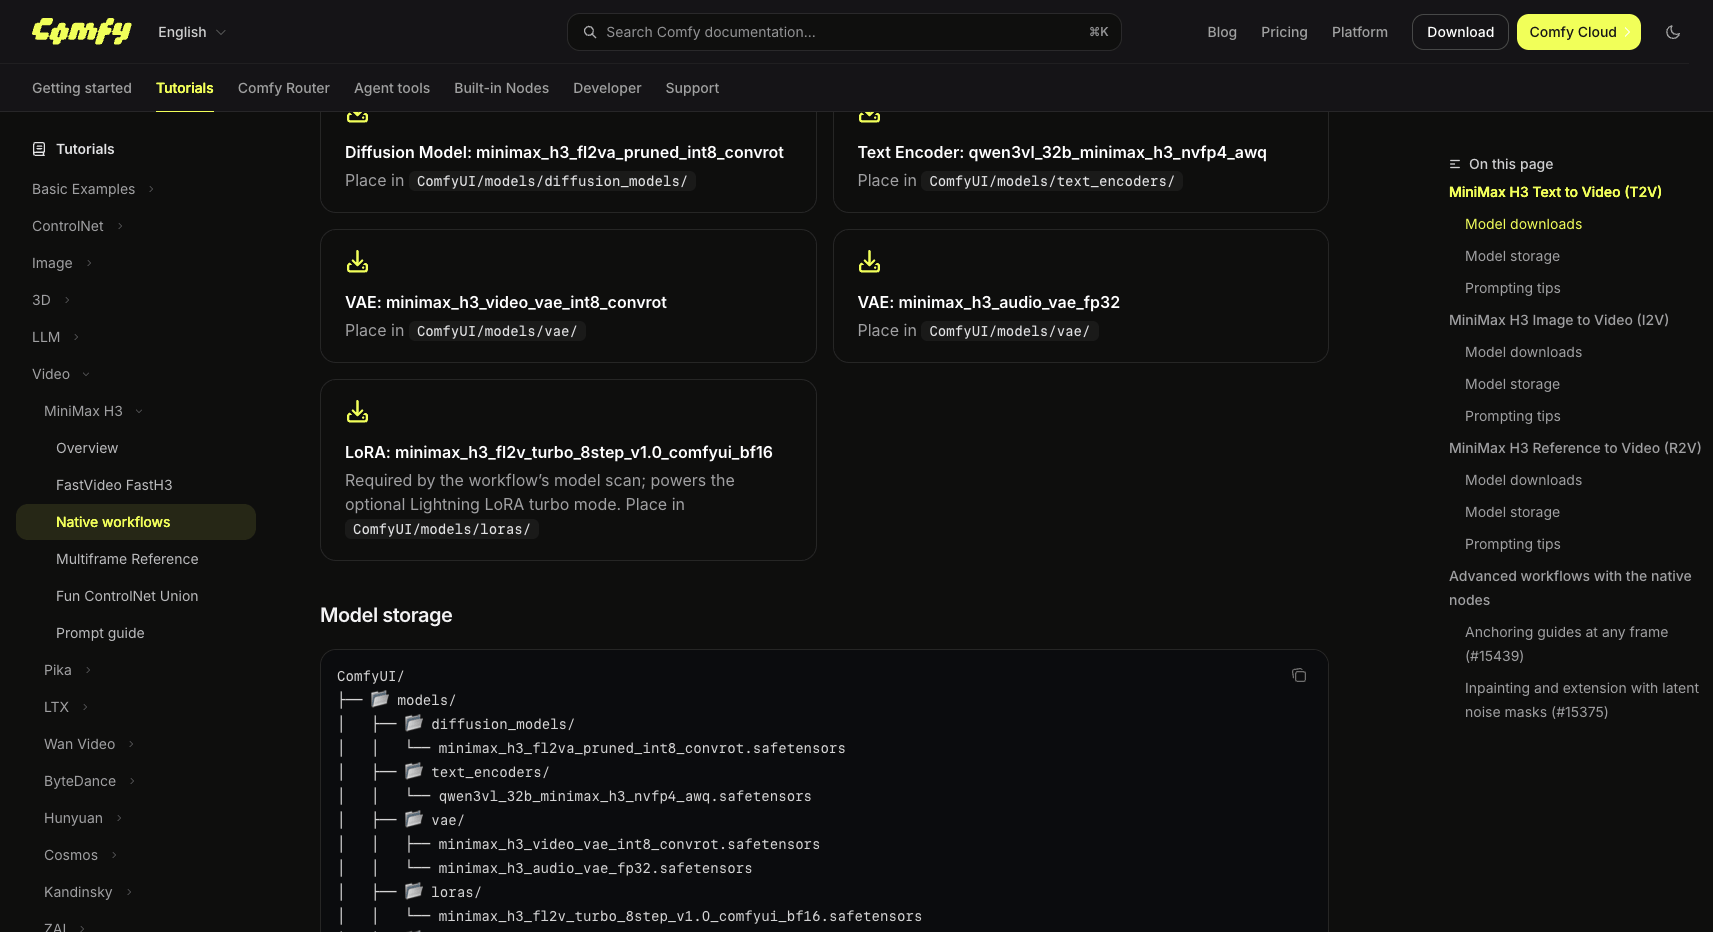
ComfyUI 官方文档:模板模型文件与放置目录(I2V 模板使用相同文件集)。来源:docs.comfy.org,2026-11-04 访问。
下载之前先掂量体积:常用量化版本下,一次 H3 渲染要碰约 21 GB 扩散模型、16 GB 文本编码器和 4 GB VAE——算下来 40 GB 出头,然后才是 LoRA 那 149 MB。Comfy-Org 建议在 CUDA 13.0+ 的 PyTorch 上用 int8_convrot 版本,跑不了再退到 fp8_scaled;nvfp4 文本编码器不要求 Blackwell 显卡。
正式生成后,官方模板文档里有两条实操规则要记住:
- 分辨率和时长会吸附到网格。 原生 16:9 是 1344×768(边长 32 的倍数),时长按 24 FPS 吸附到 17k+5 帧。I2V 模板打开时是很小的 1:1 画布(640×640,0.4 MP)——出成片前记得调高 Megapixels。
- 首帧和尾帧的行为不一样。
first_frame会被缩放到画布,比例不合的图会被拉变形;last_frame则是居中裁切。
投入时间之前还要确认一件事:H3 开源权重采用 MiniMax H3 Community License,本地生成内容的商用需要 MiniMax 商业授权(Comfy 是官方经销渠道)。VBVR LoRA 本身是 Apache 2.0,但管住你产出的是底模条款。
安装 VBVR LoRA
- 下载 LoRA:LiconStudio 仓库里的
H3-Licon-VBVR-I2V.safetensors(149 MB)。 - 放进
ComfyUI/models/loras/——和模板里那个可选提速 LoRA 同一个文件夹。 - 在工作流的 LoRA 加载器中选中它。模型卡唯一声明的要求是"兼容 MiniMax-H3 的图生视频工作流"——VBVR 针对的是 FL2VA/I2V 路径,不是 Ref2VA 参考生成 checkpoint,别加载错。
- 设置强度与步数。 模型卡没有给出推荐强度,也没有说明其验证视频用的采样 schedule——ComfyUI LoRA 加载器默认强度 1.0,从默认值起步即可。一个提醒:模板里可选的 8 步 turbo 模式是单独的提速 LoRA,不是 VBVR。要做干净的对比,让基线和 VBVR 两版在相同 schedule、相同提示词、相同 seed 下各跑一次。
- 两边都跑一遍。 唯一有意义的评估是你自己提示词上的 A/B 对照——看点见下文。
效果对比:官方发布的内容说明了什么
仓库带六个验证样例(validation/1 到 6),每个都包含条件图、提示词和两条视频:原始 H3-FL2VA 输出对比 H3 加 VBVR。这些是作者自己发布的演示——不是独立评测,设定预期时要记住这个区别。
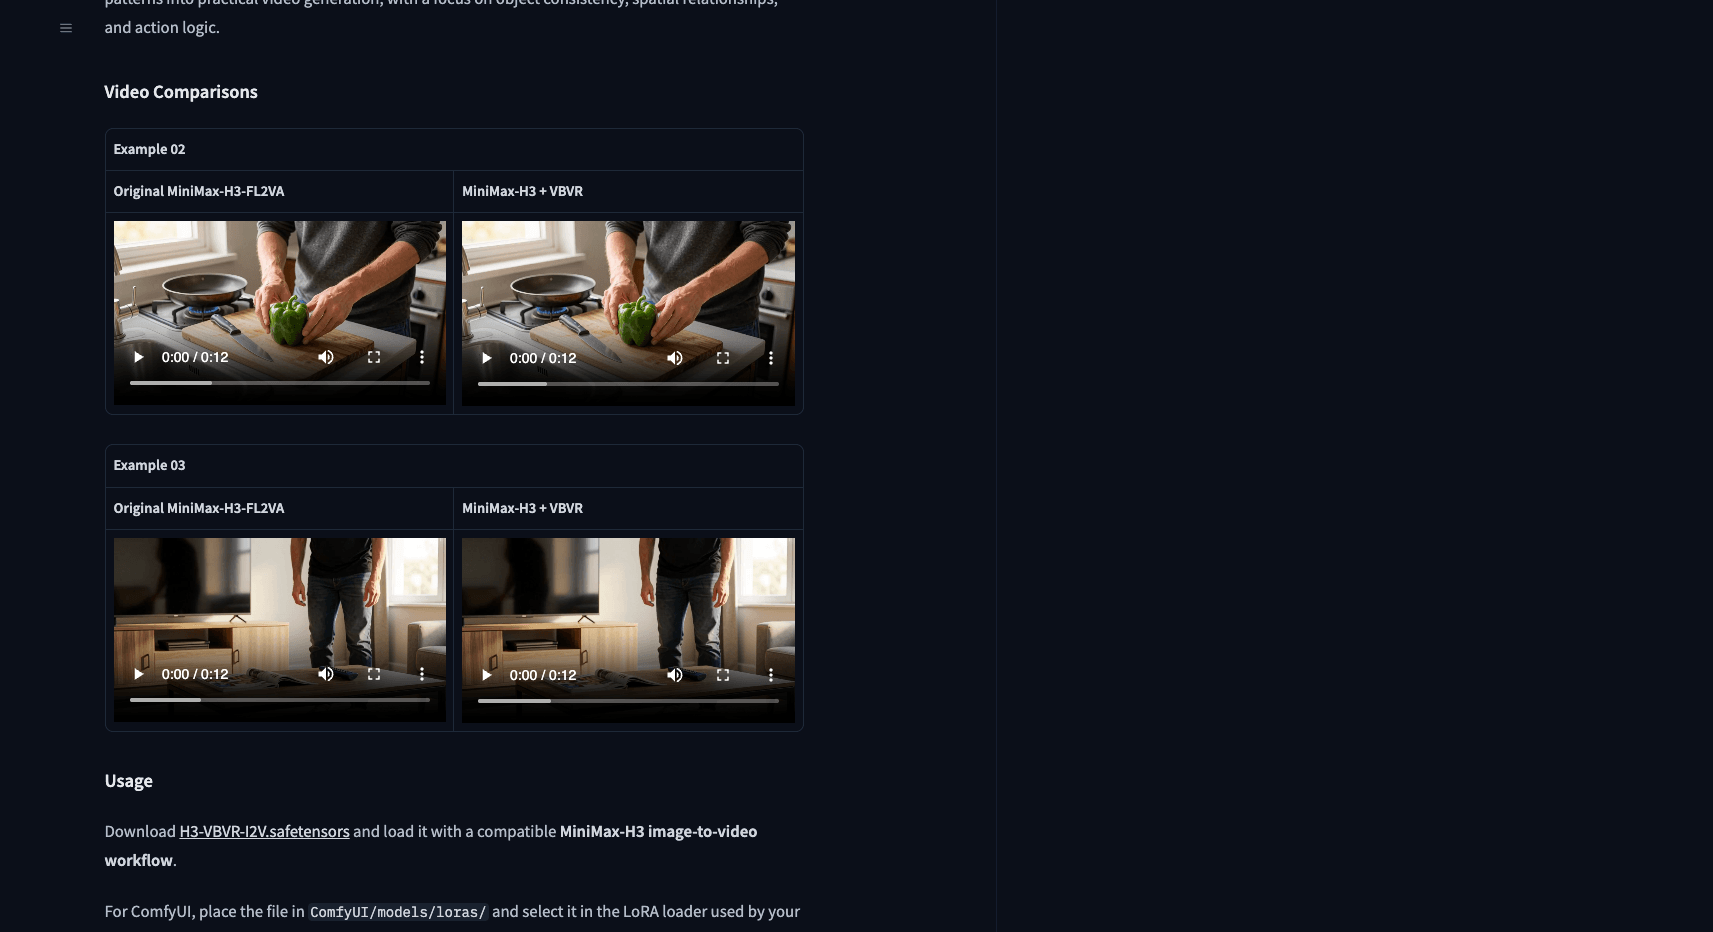
模型卡上作者发布的同屏对比示例。来源:huggingface.co/LiconStudio/Minimax-H3-VBVR,2026-11-04 访问。
第一个样例最能说明训练思路:写实风格的水果摊,提示词要求顾客一次一个地拿起三个红苹果放进纸袋,最后袋里"恰好三个"、柜台一个不剩——并明确写了"不能切换镜头、不能复制、不能多出苹果"。计数与遮挡下的物体持续性正是 VBVR-Pro 任务反复训练的失败模式,这正是预期 LoRA 发挥作用的地方。其余样例模式相同:物体必须在运动中保住身份和数量的强交互场景。
老实说:模型卡声称的改进(更少复制、更少穿模、更连贯的动作逻辑)都只体现在作者自己发布的同屏对比视频里,可以直接在模型卡上观看。目前还没有任何独立方对这个 LoRA 做过评测。想自己判断,最省事的办法是挑一个 H3 已经"接近成功"的提示词——一个有 3–5 个物体被拿取、搬运或装袋的场景——在物体互动的那几帧逐帧对比两个版本。
没有 33B 级硬件?在线方案
本地跑 H3 是一笔实打实的投入:几十 GB 权重、带得动 33B Transformer 的 GPU 配置,而且 2K 输出依然不在本地管线里(开源版本针对约 1 MP / 768 px;2K 来自 MiniMax 托管的再生成阶段,或 ComfyUI 里单独的放大步骤)。
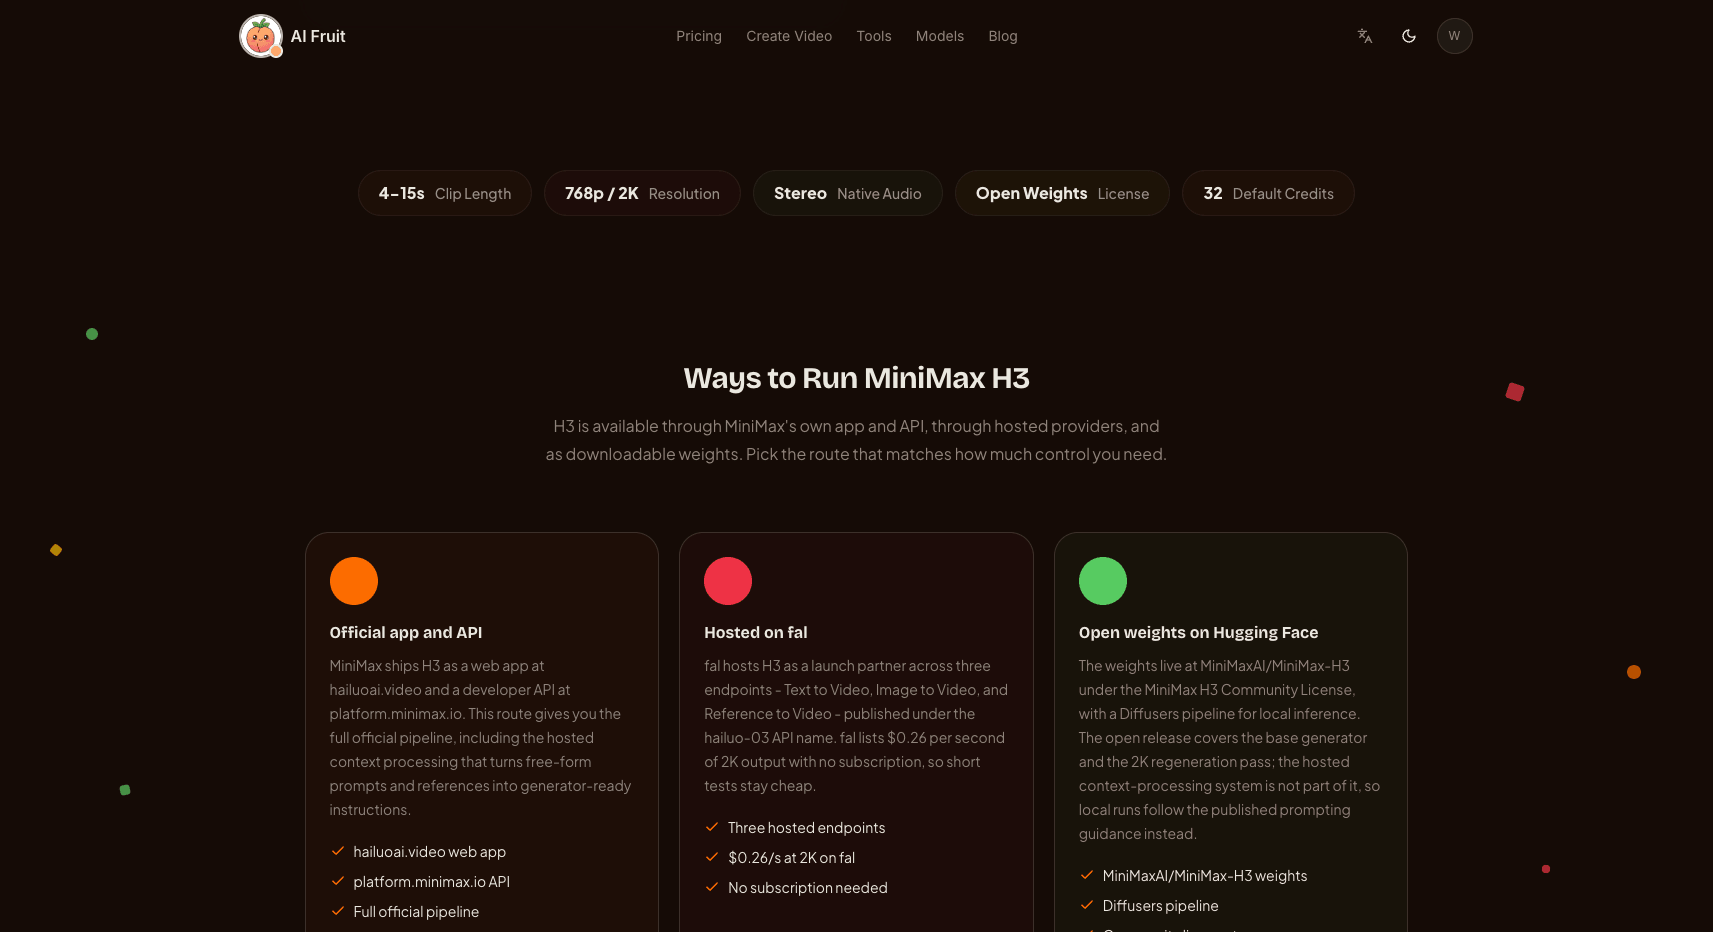
如果这超出你愿意承接的范围,底模本身有托管方案:AI Fruit 的视频生成器内置 MiniMax H3,浏览器里直接跑文生视频和图生视频,768P 或 2K 可选,无需任何本地配置——想先看看 H3 在高一致性提示词上的表现、再决定值不值得搭本地 LoRA 环境,可以直接试。注意托管生成器跑的是底模;VBVR LoRA 是本地工作流的附加组件,托管端不提供。在 AI Fruit 生成器里试用 MiniMax H3
想在 H3 上走得更远,还有两篇站内阅读:FastH3 Omni 介绍 FastVideo 的 8 步蒸馏 H3 checkpoint(本地提速),MiniMax H3 Timeline 插件介绍 ComfyUI 里的分镜多镜头工作流。
结论
VBVR LoRA 是昂贵底模上一个便宜、目标明确的实验:149 MB 对约 40 GB,解决的是具体的一致性失败而非泛泛的画质。如果你的 H3 视频反复出现物体复制或动作逻辑断裂,它是目前少数公开、可复现、正面解决这个问题的方案——而且附带的同屏证据在下载之前就能核验。装进 LoRA 加载器,同一提示词跑两遍,在物体必须"经得起互动"的那些镜头上做判断。