
AI 配音新标杆:用登顶 Coval 基准的 Qwen3-TTS 给短视频配旁白
Nari Qwen3-TTS/ASR 登顶 Coval 语音 AI 基准(2026-09-14),价格只有 ElevenLabs 的五分之一。这对短视频配音意味着什么、怎么用:从写脚本、一个 HTTPS 请求生成旁白到进剪辑时间线的完整流程。
视频做完之后配上旁白,是发布前的最后一公里——而从 2026 年 9 月 14 日起,这一公里变得异常便宜。Nari Labs 宣布其 Qwen3-TTS 与 Qwen3-ASR 端点登顶 Coval 语音 AI 基准:在公开可用模型中,文本转语音准确率第一、语音识别延迟第一,价格却只有 ElevenLabs 和 Cartesia 的五分之一到六分之一。如果你需要给短视频加 AI 配音——口播开场、产品演示、无人出镜短片——一个新的事实默认选项出现了。
本文先说清楚这次基准登顶对短视频创作者到底意味着什么,再给出一套基于官方文档的工作流:用 Nari Qwen3-TTS 生成旁白,放进剪辑时间线。丑话说在前面:Coval 榜单大约每 30 分钟刷新一次,下文所有数字都是带时间戳的快照,不是永久事实。
发生了什么
Coval 运营着持续更新的语音 AI 排行榜,衡量延迟(TTS 的首段音频时间 TTFA、STT 的末段文本时间 TTFS)和词错率(WER)。根据 Nari 的公告——基于 Coval 2026 年 9 月 14 日 15:00 UTC 的一天视图:
| 基准项 | 结果(9 月 14 日快照) |
|---|---|
| TTS 准确率 | Qwen3-TTS Fast:词错率 3.8%,28 个模型中第一 |
| TTS 延迟 | Qwen3-TTS Fast:中位 TTFA 63 ms 排第二,仅次于 Fluxions 的 300M 参数 vui(49 ms) |
| STT 延迟 | Qwen3-ASR Fast:中位 TTFS 44 ms 排第一 |
| STT 准确率 | Qwen3-ASR Fast:词错率 3.6% 排第二,落后于 AssemblyAI Universal 3.5 Pro(3.5%) |
我们在 9 月 15 日 00:30 UTC 前后复查了 TTS 实时榜单:Nari 仍以 3.8% 的词错率保持第一,vui 的中位 TTFA 则显示为 51 ms。STT 榜面已有变化——Baseten 的 Qwen3-ASR 专用端点以 22 ms 领跑 TTFS,词错率第一是 AssemblyAI 的 3.4%。排名会浮动;真正稳定、值得记住的是它的价格性能位置,而不是某天某一行的具体名次。
价格才是创作者真正能感受到的部分。Nari TTS Fast 端点每百万字符 10 美元,在 Coval 价格目录中并列最便宜;Standard 端点 5 美元,是全场最低。Nari 的公告对比:ElevenLabs Eleven v3 Conversational 是它的 5 倍,Cartesia Sonic 3.6 是 6.5 倍。STT 方面,Fast 每小时音频 0.12 美元、Standard 0.06 美元,而 AssemblyAI Universal 3.5 Pro 是 0.45 美元,Deepgram Nova 3 约 0.29 美元。
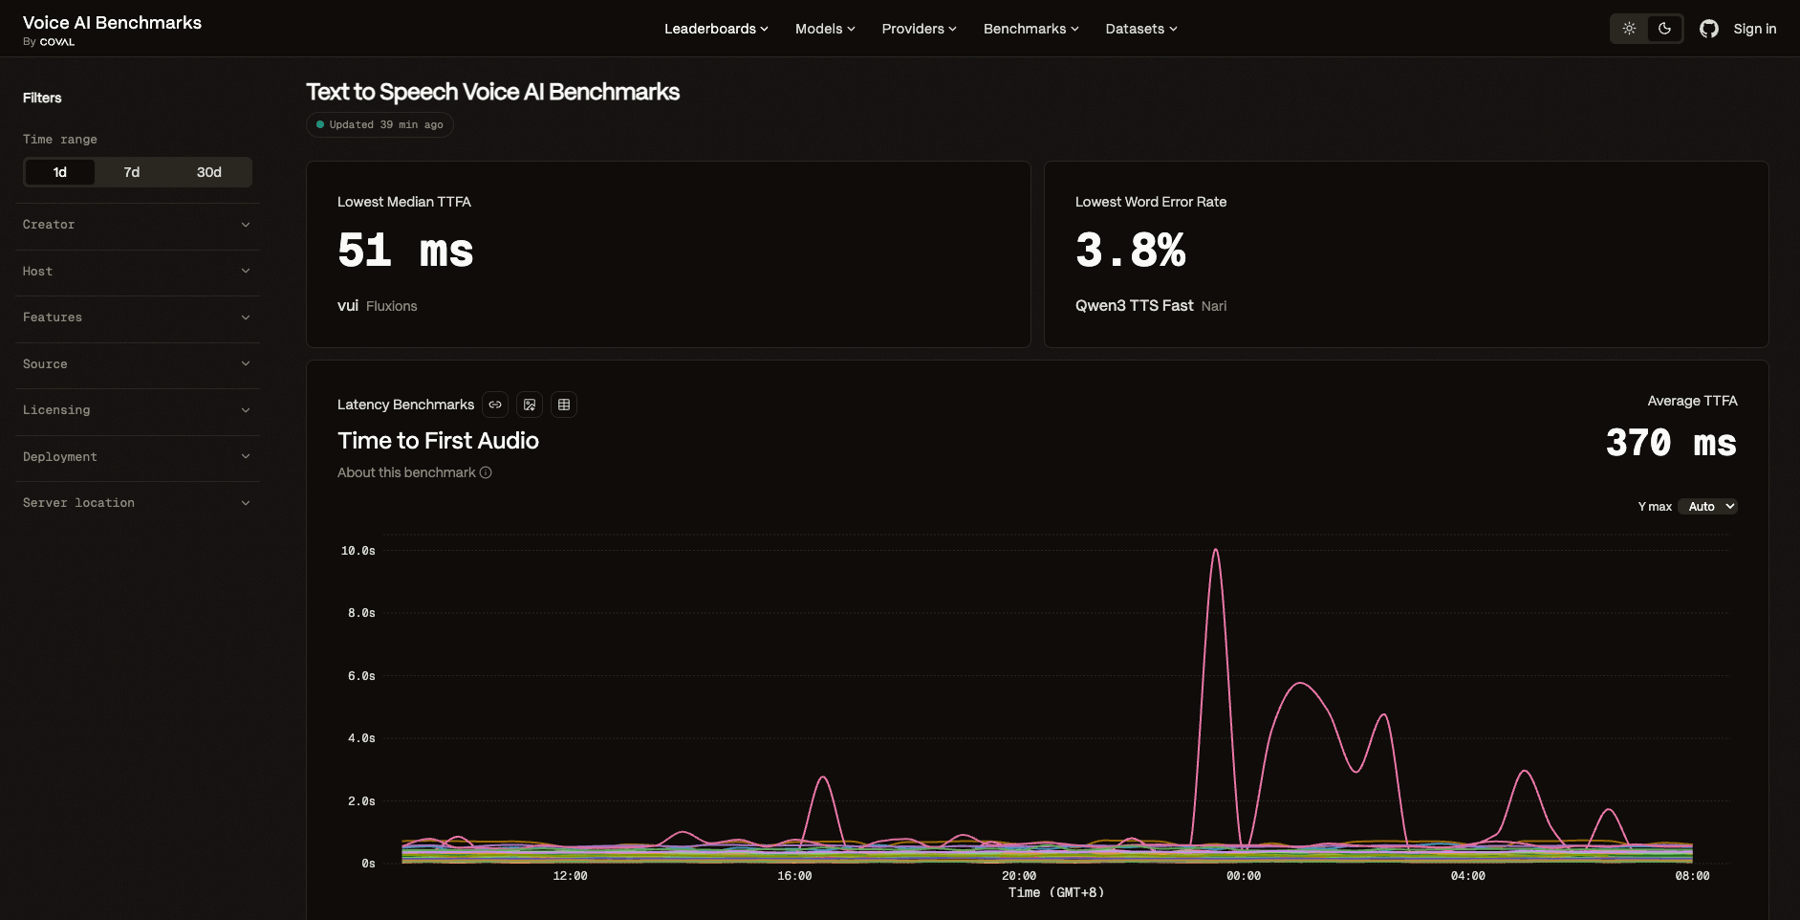
Coval TTS 榜单,查于 2026 年 9 月 15 日 00:29 UTC 前后(一天视图)。来源:benchmarks.coval.ai——数值约每 30 分钟刷新。
数据里还藏着一个重要细节:同一个 Qwen3-TTS 模型,由不同厂商部署,成绩天差地别。阿里巴巴官方的 Qwen3 TTS Flash Realtime 端点词错率 8.8%、中位 TTFA 692 ms;Baseten 的专用部署是 6.0% 和 101 ms;Nari 优化后的端点是 3.8% 和 63 ms。对一个开放权重的模型来说——Qwen3-TTS 1.7B 系列已在 Hugging Face 公开发布——推理服务质量本身就是产品。这正是 Nari(Y Combinator 孵化)以"优化开源模型"定位切入的赌注。
为什么这件事关乎短视频的最后一公里
一条 30–60 秒的短视频,旁白通常在 100–160 词,约合 600 到 1,000 个字符。按 Nari Standard 每百万字符 5 美元计算,一条完整配音大约半美分;就算你每句台词都重新生成十遍,单条视频也花不到 5 美分。所以现在选 TTS 端点,早就不该只看价格——要看迭代速度,而这正是基准数字直接兑现的地方:首段音频时间越短,你第四遍改写某句台词时的反馈就越快。
延迟也是两个档位的分界线。Nari Fast 端点(标称 50 ms TTFA)是为需要与真人实时对话的语音 agent 准备的;Standard 端点(200 ms)面向批处理。渲染配音文件是批处理任务——但如果你的流程是边听边试、逐句调整,Fast 的低延迟能明显减少来回摩擦,代价是每字符价格翻倍。
怎么用 Qwen3-TTS 给视频加 AI 配音
下面是流程说明基于文档整理——来自 Nari 产品页和公告,不是我们自己的生产实测。Nari 目前处于免费公测,按公告将在 9 月 14 日那一周内转为付费 GA,切换前注册的账号会获赠 20 美元额度——动手前值得先确认当前状态。
第一步——按口语习惯写脚本,逐行拆分。 旁白脚本和画面文案不一样:短句、不玩括号插入语、数字按读法写。一行一个意思;逐行结构让后面的对时和重生成变得极其简单。
第二步——一个 HTTPS 请求生成音频。 Nari 的 TTS API 只需向 /v1/audio/speech 发一个 POST,返回 WAV 文件;在 Fast 和 Standard 之间切换只是换一个 model ID:
curl --fail --silent --show-error \
  https://api.narilabs.com/v1/audio/speech \
  -H "Authorization: Bearer $NARI_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "qwen3-tts-fast:free",
    "input": "Your narration line here.",
    "voice": "diana",
    "response_format": "wav"
  }' \
  --output speech.wav
音色从八个预设里选(Professional、Conversational、Youthful、Mature、Narration、Energetic、Explanatory、Articulate)。注意:TTS 目前的语言支持只有英语和西班牙语——如果你的观众听别的语言,这个端点暂时帮不上那条音轨。
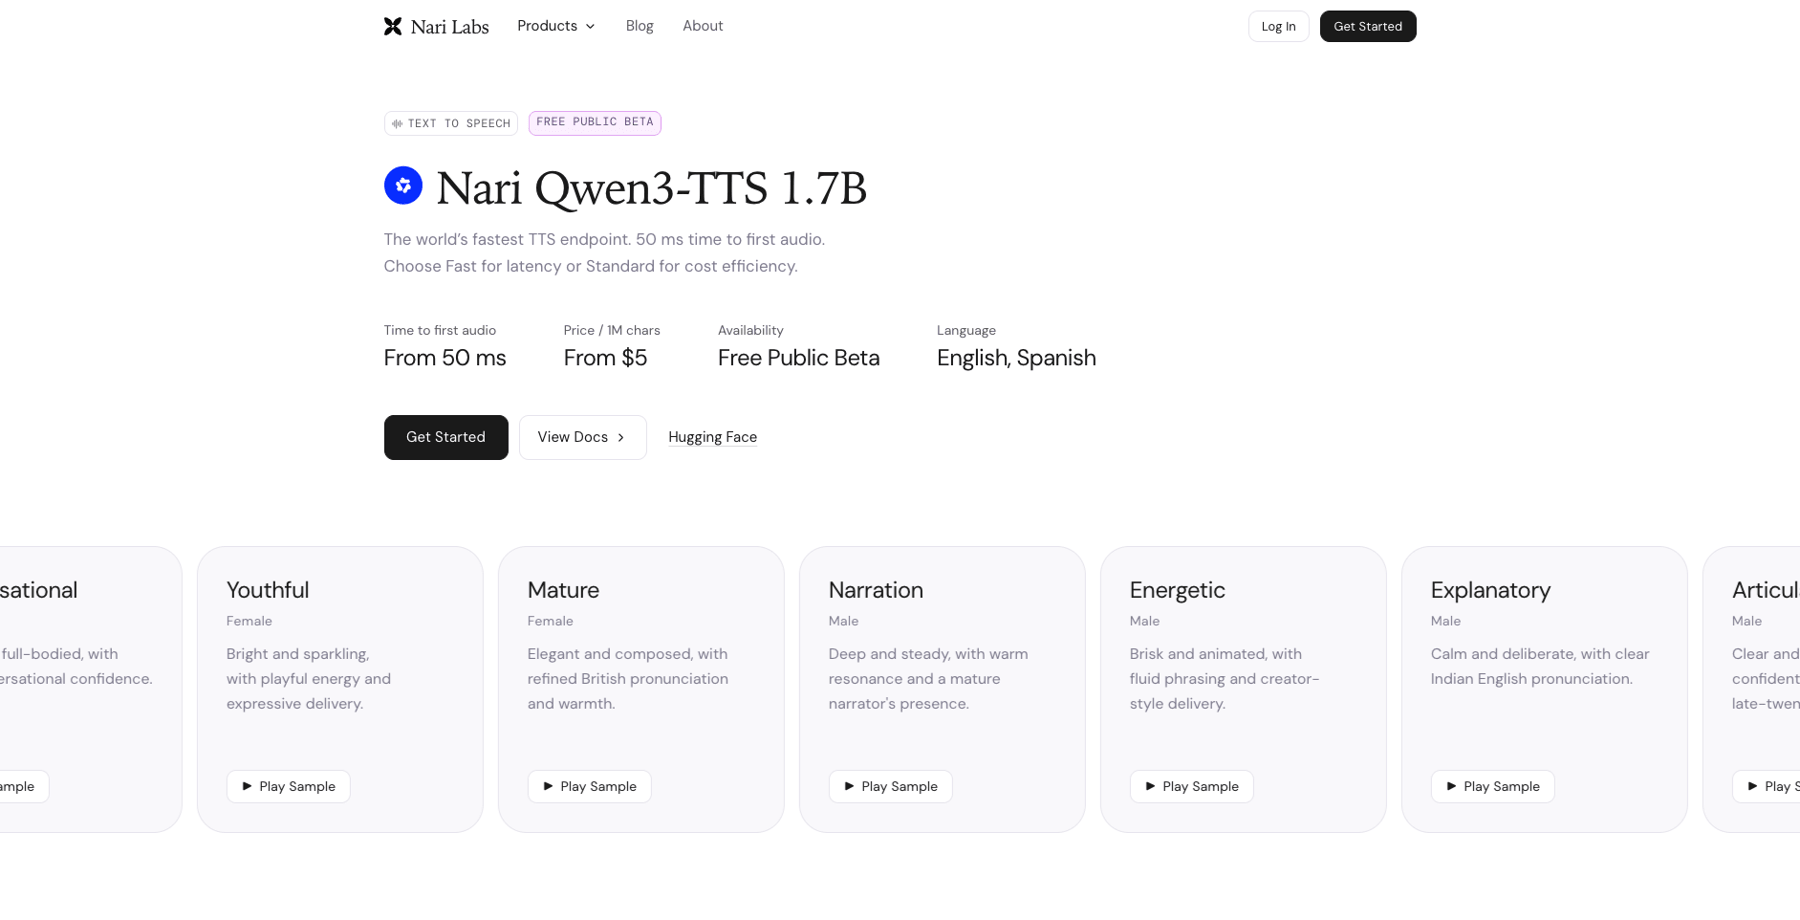
Nari Qwen3-TTS 的 Fast/Standard 两档与预设音色。来源:narilabs.com(查于 2026 年 9 月 15 日,当时为免费公测)。
第三步——把 WAV 拖进剪辑软件,对齐切点。 无论用剪映、Premiere 还是 Resolve,把每句旁白铺在独立音频片段上,贴着画面切点微调。生成式旁白的实操诀窍:重生成"句",不是重录"段"。在这个价格下,修一句听起来平淡的台词就是一次 API 调用,而不是一次返工。
第四步——导出,然后配字幕。 字幕和转录这条线上基准故事同样成立:9 月 14 日快照中 Nari Qwen3-ASR Fast 的 STT 延迟排第一,通过 WebSocket API 支持 30 种语言的自动语种识别。给自己的旁白轨生成 SRT,就是同一套流程反着走一遍。
Fast 还是 Standard
| Fast | Standard | |
|---|---|---|
| 标称延迟 | 50 ms TTFA | 200 ms TTFA |
| TTS 价格 | 10 美元 / 百万字符 | 5 美元 / 百万字符 |
| 适合 | 交互式试音、语音 agent | 批量旁白渲染 |
对大多数发布流程,Standard 是合理默认——反正渲染可以等。当你的工作流变得交互式时再切 Fast:试音色、对着时间线逐句改,或者搭建一个实时说话的 agent。
几句实话
- 语言覆盖:TTS 目前只支持英语和西班牙语。ASR 侧覆盖 30 种语言,但生成旁白这个能力今天的适用面还窄。
- 公测转 GA:免费端点原计划在公告一周内转付费。价格和免费额度现在可能已经变了。
- 词错率不等于表现力:WER 衡量的是可懂度,不是声音能不能打动人。词错率第一不代表 Narration 音色在你的垂类比 ElevenLabs 更抓人——押注一个频道之前先试听。
- 我们没有实测:本文流程基于文档整理,我们没有自己跑过音质评测或生产渲染。
- 排名会浮动:Coval 榜单约 30 分钟刷新一次,且排名不含专用推理端点。任何要紧场合引用前先核对当时数字。
配音在 AI 视频流水线里的位置
对短视频创作者,流水线现在是这样:生成或拍摄画面,加旁白,发布。如果卡住你的是画面——比如给 TikTok 做水果风格的 AI 短片——那是一个视频生成问题,也是 AI Fruit 负责的那一步:从提示词到视频,花钱前就能看清模型选项和积分成本。旁白是隔壁那一步,也就是本文讲的:一段脚本、一次 TTS 请求、一遍时间线。
9 月 14 日这条基准新闻的真正启示,不是某一行排名变了,而是旁白这一步——过去要么自己录、要么付订阅费——现在只要几美分、毫秒级返回,而且背后是开放权重的模型家族。最后一公里变短了,走过去就是了。
还差第一步? 用 AI Fruit 生成你的视频,配音交给当天榜首的端点。